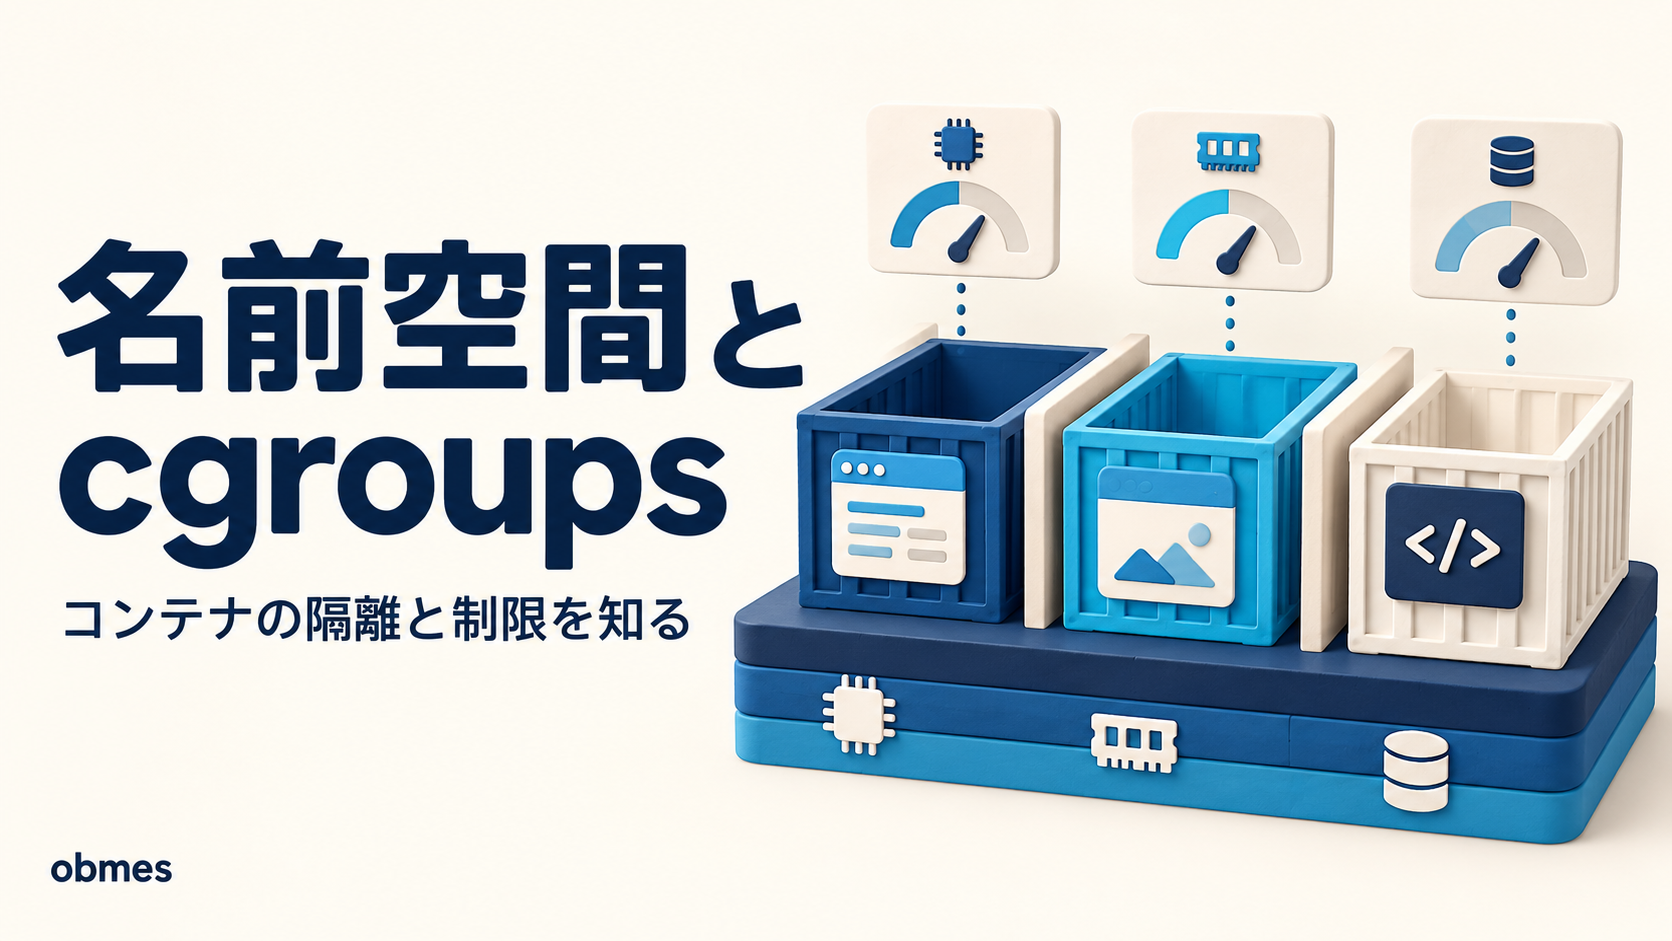
コンテナの正体は、カーネルの2つの機能です。名前空間とcgroupsを直接触って、隔離の中身を確かめます。
これは【深掘り】の記事です。本線の順路ではありません。 読まなくても先へ進めます。 本線の コンテナは軽い仮想マシンではない — Dockerの導入 の続きとして、「では、コンテナとは何なのか」を、Docker を使わずに手で作って確かめます。
前回: Linuxの起動プロセス GRUB・initramfs — 止まったら見る場所は5つ
この記事のコマンドは、すべてVMの中(Ubuntu Server)で打ちます。 Windows の PowerShell では打ちません。
前提: systemctlのstartとenableの違い|サービスの状態を確認する手順、Linuxのパーミッション|Permission deniedの原因とrwx・755の読み方、コンテナは軽い仮想マシンではない — Dockerの導入 を一度触っていること。 プロセスそのもの(シグナル・PID・
/proc)は Linuxのプロセスとシグナル|kill -9 を最初に打たない理由 で扱ったので、この記事では繰り返しません。 この記事は VM のメモリを意図的に食い潰し、プロセスを OOM で殺します。先にスナップショットを取ってください。
本線の Dockerの導入で、私はこう書きました。
❌ 「コンテナは軽い仮想マシン」 — この説明は間違いです。
間違いだと書いたのに、では何なのかを説明できていませんでした。 「カーネルを共有しているプロセスです」と書いて終わりにしていました。読み返して、これは説明になっていないと思いました。
- プロセスなら、なぜ
psを打つと自分しか見えないのか - プロセスなら、なぜ
/の中身がホストと違うのか - プロセスなら、なぜ別のIPアドレスを持てるのか
docker run --memory=64mは、いったい誰が守っているのか
これは「Dockerが頑張っている」という話ではありません。 Docker は、Linuxカーネルが元から持っている機能を呼んでいるだけです。
この記事で最初に受け取ってほしいのは、これ1つです。
コンテナは、Linuxカーネルの2つの機能の組み合わせです。
機能 何をするか 一言でいうと 名前空間(namespace) プロセスから「見える範囲」を切り離す 隔離 cgroups(control groups) プロセスが「使える量」に上限をつける 制限 どちらもカーネルの機能で、Docker が無くても使えます。 この記事ではDocker を1行も使わずに、両方を手で作ります。
「軽いVMではない」の意味も、ここで初めて腑に落ちます。 VMはもう1つのカーネルを丸ごと動かしますが、名前空間がやっているのは見え方を変えることだけです。カーネルは1つのままです。 それを uname -r で両側から確認します。
対象レベル: 中級〜上級 / 区分: 発展
この記事でわかること
- コンテナは「隔離(名前空間)」と「制限(cgroups)」の2つでできていること。どちらもカーネルの機能で、Docker はそれを呼んでいるだけだということ
- 名前空間は「仮想化」ではなく「見える範囲の切り替え」であること。カーネルは1つしかないので、
uname -rは内側でも外側でも同じ値になる docker execで入るとプロセスが数個しか見えないのは、PID名前空間のせいであること。ホスト側からは全部見えている(=隠れているだけで、消えてはいない)docker run --memoryは、/sys/fs/cgroupの中の1つのファイルに書き込まれているだけだということ。同じことはsystemd-runでも.serviceのユニットでもできるExited (137)の正体が cgroups の OOM Killer であること- root は「全能の1人」ではなく、細かい権限(capabilities)の束であること。
--privilegedはその束を全部渡すこと - コンテナの隔離は完全ではないこと。カーネルは共有しているので、VMと使い分ける必要がある
この記事でやること
unshareで PID名前空間を作り、psで自分が PID 1 に見えるのを確かめる- マウント名前空間とネットワーク名前空間を作り、そこだけ別世界になることを見る
uname -rを内側と外側で打ち比べ、カーネルが1つであることを確認するsystemd-runでメモリ上限を付け、実際に OOM でプロセスを殺させる- CPU を 50% に制限し、
topで取り分が半分になるのを見る - Docker のコンテナを起動し、
--memoryと--cpusが/sys/fs/cgroupのファイルになっていることを突き合わせる docker execの中と、ホストのps auxを見比べる- 作ったものを全部片づける
先に知る言葉
この記事で初めて出てくる言葉です。 基本的な言葉は用語集にもまとめてあります。
| 言葉 | 意味 |
|---|---|
| カーネル | OSの中心部分。メモリ・CPU・ディスクをプログラムに配る係。Linux とは本来これのこと |
| 名前空間(namespace) | プロセスごとに「見える一覧」を分ける仕組み。同じものを見ているのに、見える範囲が違う |
| cgroups | Control Groups。プロセスのグループに、メモリやCPUの上限を決める仕組み |
unshare | いまのプロセスを、指定した名前空間から切り離して新しいものを作るコマンド |
lsns | いまシステムにある名前空間の一覧を見るコマンド |
ip netns | ネットワーク名前空間を名前を付けて作るコマンド。iproute2 に入っている |
| tmpfs | メモリ上に作るファイルシステム。再起動すると消える。/tmp などで使われる |
| OOM Killer | Out Of Memory Killer。メモリが尽きたときに、カーネルがプロセスを選んで殺す仕組み |
| capabilities | root の権限を40個以上に分割したもの。「ポート80を開ける権限」などが個別にある |
systemd-run | その場かぎりの systemd ユニットを作ってコマンドを走らせるコマンド |
| スコープ(scope) | systemd が管理する単位のうち、「自分で起動したプロセスを、後から systemd の管理下に入れた」もの |
名前空間は7種類ある
まず全体像を置きます。 名前空間は1つではなく、種類ごとに独立して切り離せます。
| 種類 | 切り離すもの | 切り離すと何が変わるか | unshare のオプション |
|---|---|---|---|
| PID | プロセス番号の一覧 | 自分が PID 1 に見える。 外のプロセスが ps に出ない | --pid --fork |
| Mount | マウントの一覧 | そこだけ別のディレクトリ構成にできる | --mount |
| Network | ネットワーク機器・IP・ルーティング・ポート | 別のIPを持てる。 同じポート80を何個も開ける | --net |
| UTS | ホスト名とドメイン名 | 中だけ別のホスト名にできる | --uts |
| IPC | プロセス間通信の領域(共有メモリなど) | 外のプロセスと共有メモリをやり取りできなくなる | --ipc |
| User | ユーザーIDとグループIDの対応 | 中では root、外では一般ユーザーにできる | --user |
| Cgroup | cgroup の階層の見え方 | 自分の cgroup がルートに見える | --cgroup |
UTSは UNIX Time-sharing System の略で、ホスト名のことです。 名前から中身が推測できない、歴史的な名前です。hostnameを分けるためだけの名前空間だと思って構いません。
Docker が docker run のときにやっているのは、この7つをまとめて作ることです。 逆にいえば、1つずつバラバラに作ることもできます。 それを次でやります。
いま存在する名前空間は、lsns で一覧できます。
        NS TYPE   NPROCS   PID USER   COMMAND
4026531834 time      112     1 root   /sbin/init
4026531835 cgroup    112     1 root   /sbin/init
4026531836 pid       112     1 root   /sbin/init
4026531837 user      112     1 root   /sbin/init
4026531838 uts       112     1 root   /sbin/init
4026531839 ipc       112     1 root   /sbin/init
4026531840 mnt       105     1 root   /sbin/init
4026531992 net       112     1 root   /sbin/init
何もしていない状態でも、名前空間は既に存在しています。 これが既定の名前空間で、ほぼ全プロセスがここに属しています。「名前空間が無い状態」というものは無く、常にどれかに属しています。
NS の列の数字は、名前空間の識別子(inode番号)です。 この数字が同じなら同じ名前空間、違えば別の名前空間です。あとで比較に使います。
Dockerを使わずに名前空間を作る
ここからは、Docker を1行も使いません。 素の Ubuntu に最初から入っているコマンドだけでやります。
① PID名前空間 — 自分が PID 1 になる
まず、いまの自分の PID を見ておきます。
いまのシェルのPID: 1841
112
112個のプロセスが見えています。 ここで、PID名前空間を作ります。
プロンプトが root@ubuntu:~# に変わります。 ここから先は、新しい PID名前空間の中です。
この中でのPID: 1
    PID TTY          TIME CMD
      1 pts/0    00:00:00 bash
      9 pts/0    00:00:00 ps
プロセスが2個しか見えません。 そして、さっきまで 1841 だった自分が、PID 1 になっています。
ここで誤解しないでください。 112個のプロセスが消えたわけではありません。 全部そのまま動いています。この名前空間からは見えないだけです。 PID 1841 のプロセスが PID 1 に変わったのでもありません。 同じ1つのプロセスに、2つの番号が付いている状態です。外から見れば 1841、中から見れば 1。
3つのオプションには、それぞれ理由があります。
| オプション | 意味 | 外すとどうなるか |
|---|---|---|
--pid | PID名前空間を新しく作る | — |
--fork | 新しい子プロセスを作ってから、そちらを名前空間に入れる | bash: fork: Cannot allocate memory で失敗する |
--mount-proc | /proc を新しくマウントし直す | ps にホストの112個がそのまま見えてしまう |
--fork が要る理由は、PID名前空間の仕様です。 unshare を呼んだプロセス自身は、新しい名前空間に入りません。 入るのはその次に作られる子プロセスからです。「PID 1 は最初に作られたプロセス」でなければならないので、こうなっています。
--mount-proc が要る理由が、この記事で一番面白いところです。
psは、カーネルに問い合わせているのではありません。/procの中のディレクトリを数えているだけです。 PID名前空間を作っても、/procは前のままマウントされています。 だから、古い一覧が見え続けます。--mount-procは、マウント名前空間も一緒に作って、/procを新しくマウントし直します。 PIDの隔離とマウントの隔離は、セットで初めて意味を持ちます。
確かめます。--mount-proc を外して、もう一度やってみます。
まず、いまの名前空間から抜けます。
PID: 1
112
自分は PID 1 なのに、112個が見えています。 隔離が半分しかできていない状態です。
[スクリーンショット: 01_unshare_pid.png] sudo unshare --pid --fork --mount-proc /bin/bash を実行し、その中で echo $$ と ps -e を打って、PID が 1 で、プロセスが2個しか見えないところを撮ってください。
② カーネルは1つ — 隔離であって仮想化ではない
ここが本線の記事で書ききれなかったところです。
もう一度 PID名前空間に入って、カーネルのバージョンを見ます。
この値をメモしてください。 次に、
6.8.0-45-genericまったく同じ値です。 当たり前です。動いているカーネルは1つしかありません。
ここで、VMとの違いがはっきりします。
| 仮想マシン(VMware) | コンテナ(名前空間) | |
|---|---|---|
| カーネル | ゲスト専用のものが別に動く | ホストのものをそのまま使う |
uname -r | ホストと違う値が出る | ホストと同じ値が出る |
| 起動時間 | 数十秒(カーネルの起動から) | 一瞬(プロセスを1つ作るだけ) |
| メモリ | ゲストOSの分を丸ごと確保 | プロセス1個分 |
| 別のOSを動かせるか | できる(Windows も動く) | できない(Linuxのカーネルしかない) |
これが「軽い」の正体です。 コンテナが軽いのは、軽量化したからではなく、そもそもOSを起動していないからです。やっているのはプロセスを1つ
forkすることだけで、それはプロセスの回で見たとおり一瞬で終わります。そして、これがコンテナの限界でもあります。 カーネルが1つということは、Linux のコンテナで Windows は動かせないし、カーネルに問題があれば全コンテナが道連れだということです。この記事の最後でもう一度触ります。
[スクリーンショット: 02_uname_same.png] ホスト側と unshare の中で uname -r を打ち、同じ値が出ているところが両方写るように撮ってください。
③ マウント名前空間 — そこだけディレクトリが違う
次はマウントです。 2つのSSHセッションを使います。 VS Code のターミナルを2枚開くか、SSH でもう1本繋いでください(VS Codeから繋ぐ回)。
【ターミナルA】で、マウント名前空間を作ります。
この中で、/mnt/nsdemo にメモリ上のファイルシステムをマウントします。
inside.txt【ターミナルB】(普通のシェル)で、同じ場所を見ます。
何も出ません。 ファイルも無いし、マウントもされていません。
同じ /mnt/nsdemo という1つのパスなのに、見え方が違います。 これがマウント名前空間です。
sudoを付けているのに、なぜホスト側に影響しないのか。 権限の問題ではなく、見えている一覧が違うからです。 マウントの一覧(マウントテーブル)そのものが、名前空間ごとに別々に持たれています。root であっても、自分が居る名前空間の一覧しか触れません。
【ターミナルA】で抜けます。
抜けた瞬間、この tmpfs は消えます。 名前空間は、そこに属するプロセスが1つも居なくなると自動で消滅します。 中身も一緒に消えます。
「コンテナを消すとデータが消える」の理由が、これです。 本線の記事で -v を使ってホスト側にファイルを置いた理由が、ここで繋がります。
④ ネットワーク名前空間 — そこだけ別のネットワーク
ネットワークは、unshare --net でも作れますが、ip netns を使うほうが分かりやすいです。 名前を付けて作れて、後から何度でも入れるからです。
nsdemoこの中に入って、ネットワーク機器の一覧を見ます。
1: lo: <LOOPBACK> mtu 65536 qdisc noop state DOWN group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
ホスト側と見比べます。
1: lo: <LOOPBACK,UP,LOWER_UP> mtu 65536 qdisc noqueue state UNKNOWN group default qlen 1000
    link/loopback 00:00:00:00:00:00 brd 00:00:00:00:00:00
    inet 127.0.0.1/8 scope host lo
2: ens33: <BROADCAST,MULTICAST,UP,LOWER_UP> mtu 1500 qdisc fq_codel state UP group default qlen 1000
    link/ens33: ...
    inet 192.168.1.50/24 brd 192.168.1.255 scope global ens33
新しい名前空間には ens33 がありません。 そして、lo(ループバック)すら DOWN です。
新しいネットワーク名前空間は、機器が何も無い、真っ白な状態で作られます。 ホストのIPも、ルーティングも、ufw のルールも、何一つ引き継ぎません。
通信できないことを確かめます。
ping: connect: Network is unreachable自分自身にすら届きません。 lo が上がっていないからです。上げます。
PING 127.0.0.1 (127.0.0.1) 56(84) bytes of data.
64 bytes from 127.0.0.1: icmp_seq=1 ttl=64 time=0.031 ms
自分には届くようになりました。 ただし、外には出られません。
ping: connect: Network is unreachableここが、Docker のネットワークが分かりにくい理由の根っこです。 新しいネットワーク名前空間は、外と繋がる線を1本も持っていません。 繋ぐには、仮想のLANケーブル(veth ペア)を作って、片方を名前空間の中、片方をホストのブリッジに挿すという作業が要ります。
docker0というブリッジと、docker runのたびに増えるveth...という機器は、これをやっています。 Docker が親切にやってくれているだけで、「コンテナだから勝手に繋がる」のではありません。 ここを手で組むのはIPとルーティングの回の続きになるので、この記事では「線が無い状態から始まる」ことを見るところまでにします。
もう1つ、大事な帰結があります。
ネットワーク名前空間が別なら、同じポート番号を何個でも開けます。 ホストで
80を使っていても、名前空間の中の80はまったく別のポートです。「ポート80が既に使われています」がコンテナで起きない理由がこれです。 逆に、docker run -p 8080:80の-pは、この2つの世界の間に穴を開ける指定です。リバースプロキシの回でポートを付け替えたのと、考え方は同じです。
[スクリーンショット: 03_ip_netns.png] sudo ip netns exec nsdemo ip addr と、ホスト側の ip addr を並べて、中には機器が lo しか無いことが分かるように撮ってください。
⑤ UTS名前空間 — ホスト名だけ変える
一番小さい例なので、最後に置きます。
container-demo別のターミナルで hostname を打つと、元のままです。
docker run したコンテナの中で hostname を打つと、コンテナIDの短縮形が出ます。 あれはUTS名前空間を作って hostname を設定しているだけです。
cgroups は「制限」の担当
名前空間は、見える範囲を切りました。しかし、それだけでは足りません。
名前空間の中のプロセスは、ホストのメモリを全部使えます。CPUも全部使えます。 見えないだけで、使えないわけではありません。
これを止めるのが cgroups です。 名前空間が隔離、cgroups が制限——役割がまったく違います。
cgroup v2 はファイルシステムに見えている
cgroups の設定は、コマンドではなくファイルです。
cgroup2fscgroup2fs と出れば cgroup v2 です。 Ubuntu 22.04 以降は v2 のみ(unified hierarchy)です。tmpfs と出た場合は v1 との併用状態です。
v1 と v2 の違いを1行で。 v1 は資源の種類ごとに別々の階層があり(メモリの木、CPUの木、…)、同じプロセスが木ごとに違うグループに属せてしまうという混乱がありました。v2 は木を1本にまとめました。 ネット上の古い記事は v1 の話(
/sys/fs/cgroup/memory/...のようなパス)が多いので、パスが違うと思ったら v1 の記事です。
使える制御の種類を見ます。
cpuset cpu io memory hugetlb pids rdma misc| コントローラ | 制限するもの | 代表的なファイル |
|---|---|---|
memory | メモリ使用量 | memory.max / memory.current |
cpu | CPU時間の取り分 | cpu.max / cpu.weight |
pids | 作れるプロセス数 | pids.max |
io | ディスクの読み書き速度 | io.max |
cpuset | 使ってよいCPU番号 | cpuset.cpus |
自分がいまどの cgroup に属しているかも、ファイルで分かります。
0::/user.slice/user-1000.slice/session-3.scope0:: の後ろがパスです。 これは /sys/fs/cgroup/ からの相対パスで、実際にそのディレクトリがあります。
SSHでログインしただけで、systemd が既にあなたを1つの cgroup に入れています。 cgroups は Docker のための仕組みではなく、systemd が普段から使っている仕組みです。
メモリ上限を付けて、OOM で殺させる
ここは実際にプロセスを殺します。 ただし、安全に殺します。
「安全に」の意味を先に書きます。 上限を付けずにメモリを食い潰すと、VM全体が固まります。 カーネルの OOM Killer が動きますが、何を殺すかを選ぶのはカーネルで、SSH のセッションや大事なサービスが選ばれることがあります。再起動するしかなくなります。 cgroups で上限を付けると、殺されるのはそのグループの中のプロセスだけです。だから安全に実験できます。
systemd-run で、その場かぎりの制限をかける
cgroup のディレクトリを手で作って、PIDを書き込んで……ということもできますが、やりません。 systemd が既に cgroup を管理しているので、手で作ったものと喧嘩します。 素直に systemd に頼みます。
Running scope as unit: memdemo.scope
Killed
数秒で Killed と出て終わります。
何が起きたか、1行ずつ分解します。
| 部分 | 意味 |
|---|---|
systemd-run | その場かぎりの systemd ユニットを作る。設定ファイルを書かずに試せる |
--scope | いまの端末で、前面で走らせる(サービスとしてバックグラウンドに送らない) |
-p MemoryMax=50M | このグループが使えるメモリの上限を 50MB にする |
-p MemorySwapMax=0 | スワップに逃がすことも禁止する(無いと、遅くなるだけで死なないことがある) |
--unit=memdemo | 名前を付ける。後で /sys/fs/cgroup を見るために必要 |
tail /dev/zero | /dev/zero を「最後の行まで」読もうとする。 終わりが無いので、読んだ分をメモリに溜め続ける |
tail /dev/zeroは、メモリを食い潰す一番短い書き方です。tailは「最後の10行」を出すために全部読んでから判断するので、終わりの無いファイルを渡すと無限に溜め込みます。 悪意のあるコマンドではなく、仕様どおりの動作です。
殺したのが誰かを確認します。
[  842.113905] tail invoked oom-killer: gfp_mask=0xcc0(GFP_KERNEL), order=0, oom_score_adj=0
[  842.114982] Memory cgroup out of memory: Killed process 2914 (tail) total-vm:53640kB, anon-rss:49280kB
Memory cgroup out of memory と書いてあります。 VM全体のメモリが尽きたのではなく、cgroup の上限に当たったということです。
終了コードを見ます。
終了コード: 137
137 = 128 + 9です。 プロセスの回でやったとおり、SIGKILLで殺されたということです。docker ps -aでExited (137)を見たことがあるなら、それはこれです。 アプリのバグでも、Docker の不具合でもなく、「メモリ上限を超えたのでカーネルが殺した」という意味です。-9なので、ログも片づけも残りません。
走っている最中の cgroup を覗く
上限が本当にファイルになっているのかを、走っている最中に見ます。
【ターミナルA】で、上限付きの sleep を走らせます。
【ターミナルB】で、そのディレクトリを見ます。
1048576003686403122| ファイル | 中身 |
|---|---|
memory.max | 上限。104857600 は 100MB をバイトで書いたもの |
memory.current | いま実際に使っている量 |
cgroup.procs | このグループに属するプロセスのPID一覧 |
MemoryMax=100M と書いたものが、memory.max というファイルの 104857600 になっています。 cgroups の設定は、これだけです。
【ターミナルA】は Ctrl+C で止めてください。
[スクリーンショット: 04_memory_max.png] cat /sys/fs/cgroup/system.slice/peek.scope/memory.max の結果と、systemd-run を打ったコマンドの両方が写るように撮ってください。
CPU を 50% に制限する
メモリの次は CPU です。 こちらは殺されるのではなく、遅くなります。
まず、VMのCPU数を確認します。
2バックグラウンドで、CPUを全力で回すループを、制限付きで起動します。
Running as unit: cpudemo.serviceさっきと違って
--scopeを付けていません。--scopeは前面で走るので、topを見るターミナルが塞がります。--scopeを外すと、その場かぎりの.serviceとして裏で起動します。 動きはsystemd のユニットの回で見た.serviceと同じです。
top で見ます。
  PID USER      PR  NI    VIRT    RES  %CPU  COMMAND
 3255 root      20   0    8340   3216  50.0  bash
%CPU が 50.0 で頭打ちになっています。 無限ループなので本来は 100% 使うはずですが、50% で抑えられています。 q で抜けます。
設定がどう書かれているかを見ます。
50000 100000cpu.max は2つの数字です。
| 数字 | 意味 |
|---|---|
100000 | 1周期の長さ(マイクロ秒)= 0.1秒 |
50000 | その周期のうち、使ってよい時間 = 0.05秒 |
「0.1秒ごとに、0.05秒だけ動いてよい」 という指定です。これが CPU 50% の実体です。割合ではなく、時間の割り当てで表現されています。
CPUQuota=200%は書けます。 CPUが2個以上あるとき、「2個ぶん使ってよい」という意味になります。100%が最大ではありません。nprocが 2 なら 200% まで指定できます。
止めます。
[スクリーンショット: 05_cpu_quota.png] top で %CPU が 50.0 前後で止まっている行と、cat .../cpu.max の結果が分かるように撮ってください。
ユニットファイルに書けば、同じことが常に効く
systemd-run はその場かぎりです。 VMを再起動すると消えます。
恒久的にしたいなら、前回のユニットファイルの回でやった drop-in に書きます。 systemd-run -p に書いたものと、まったく同じ名前が使えます。
エディタが開いたら、指定された行の間に書きます。
[Service]
MemoryMax=256M
CPUQuota=50%
TasksMax=64MemoryMax=268435456
CPUQuotaPerSecUSec=500ms| ユニットの書き方 | cgroup のファイル | 意味 |
|---|---|---|
MemoryMax= | memory.max | 超えたら OOM で殺される |
MemoryHigh= | memory.high | 超えると強く回収される(殺されはしない) |
CPUQuota= | cpu.max | 使ってよいCPU時間の割合 |
CPUWeight= | cpu.weight | 奪い合いになったときの取り分の比率 |
TasksMax= | pids.max | 作れるプロセス数の上限(fork爆弾への防御) |
MemoryMaxとMemoryHighの違いは実務で効きます。MemoryMaxは「超えたら殺す」、MemoryHighは「超えたら苦しくする(が生かす)」です。「落ちるより遅いほうがマシ」なサービスにはMemoryHighを使います。 nice の話と混同しないでください。niceはプロセス1個の遠慮の度合いで、上限ではありません。 cgroups はグループ全体に効く天井です。
元に戻します。
Docker は、この2つを呼んでいるだけ
ここまでで、隔離と制限を手で作りました。 Docker が本当に同じものを使っているのかを、確かめます。
上限を付けてコンテナを起動します。
alpineを使うのは、psが最初から入っているからです。ubuntuイメージにはpsが入っていません(procpsが省かれています)。「コンテナの中でpsが無い」は壊れているのではなく、そもそも入れていないだけです。
コンテナのプロセスが、ホストから見て何番なのかを調べます。
ホストから見たPID: 3412そのプロセスがどの cgroup に居るかを、/proc から読みます。
0::/system.slice/docker-9f3c1a....scopeこのパスを使って、上限のファイルを直接読みます。
6710886450000 100000--memory=64m は memory.max の 67108864(=64×1024×1024)でした。 --cpus=0.5 は cpu.max の 50000 100000 でした。
さっき systemd-run -p CPUQuota=50% で作ったものと、1バイトも変わりません。
cat /proc/$PID/cgroupのパスは環境で変わります。0::/docker/9f3c1a...と出ることもあります。 Docker が systemd の cgroup ドライバを使っているか、自前(cgroupfs)を使っているかで違います。どちらでも/sys/fs/cgroupからの相対パスであることは同じなので、上のCG=$(cut ...)の書き方ならどちらでも動きます。 パスを手で打ち写さないのは、こういう差を踏まないためです。
名前空間のほうも確かめます。
lrwxrwxrwx 1 root root 0 Sep 20 11:02 cgroup -> 'cgroup:[4026532393]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 ipc -> 'ipc:[4026532391]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 mnt -> 'mnt:[4026532389]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 net -> 'net:[4026532394]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 pid -> 'pid:[4026532392]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 pid_for_children -> 'pid:[4026532392]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 time -> 'time:[4026531834]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 time_for_children -> 'time:[4026531834]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 user -> 'user:[4026531837]'
lrwxrwxrwx 1 root root 0 Sep 20 11:02 uts -> 'uts:[4026532390]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 cgroup -> 'cgroup:[4026531835]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 ipc -> 'ipc:[4026531839]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 mnt -> 'mnt:[4026531840]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 net -> 'net:[4026531992]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 pid -> 'pid:[4026531836]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 pid_for_children -> 'pid:[4026531836]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 time -> 'time:[4026531834]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 time_for_children -> 'time:[4026531834]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 user -> 'user:[4026531837]'
lrwxrwxrwx 1 ubuntu ubuntu 0 Sep 20 11:02 uts -> 'uts:[4026531838]'cgroup ipc mnt net pid uts の番号が違います。 一方で、
user の番号(4026531837)は同じです。 Docker は既定でユーザー名前空間を分けていません。 これは「コンテナの中の root は、ホストの root と同じUID 0」ということで、後で触れます。 cgroup が分かれているのは、Docker が既定(default-cgroupns-mode が private)でコンテナ専用の cgroup 名前空間を作るからです(/proc/<pid>/ns には、分けていない名前空間のリンクも全部並びます)。
lsns でも見えます。
[スクリーンショット: 06_docker_cgroup.png] docker run --memory=64m --cpus=0.5 で起動したコンテナの memory.max と cpu.max を読んだ結果を撮ってください。
docker exec でプロセスが少なく見える理由
これは PID名前空間そのものです。 山場①でやったことと、まったく同じです。
コンテナの中で ps を打ちます。
PID   USER     TIME  COMMAND
    1 root      0:00 sleep 3600
   14 root      0:00 ps -ef
2行しかありません。 そして sleep 3600 が PID 1 です。
ホスト側から、同じプロセスを探します。
root 3412 3390 0 11:02 ? 00:00:00 sleep 3600ホストからは PID 3412 として、普通に見えています。
さらに、ホストの全プロセスの中に紛れていることを確かめます。
1182ここが、コンテナを理解する上で一番大事なところかもしれません。 コンテナの中のプロセスは、ホストのプロセス一覧に普通に並んでいます。 「コンテナという箱の中で動いている」のではなく、ホストで動いている1つのプロセスに、別の番号と別の視界が与えられているだけです。 だから
topをホストで打てば、コンテナの負荷もそのまま見えます。 監視のときに「コンテナの中が見えない」と困る必要はありません。外からは全部見えています。
逆向きも確かめられます。ホストから、コンテナのファイルシステムを覗きます。
bin dev etc home lib proc root sbin sys tmp usr varalpine の中身が、ホストから普通に読めます。 /proc/<pid>/root は、そのプロセスから見た / を指すリンクです。プロセスの回で /proc/<pid>/cwd を見たのと同じ仕組みです。
[スクリーンショット: 07_pid_ns_compare.png] docker exec cgdemo ps -ef(2行だけ)と、ホストの ps -ef | grep 'sleep 3600'(見えている)を並べて撮ってください。
capabilities — root は1つの権限ではない
ここまで「コンテナの中の root は、ホストの root と同じUID 0」だと書きました。 では、なぜコンテナの中の root がホストを壊せないのか。
答えが capabilities です。
Linux の root 権限は、実は40個以上の細かい権限に分割されています。 「ポート1024未満を開く権限」「時刻を変える権限」「他人のプロセスを kill する権限」などが、それぞれ独立したスイッチになっています。
代表的なものだけ挙げます。
| capability | できること |
|---|---|
CAP_NET_BIND_SERVICE | 1024未満のポートで待ち受ける(nginx が 80 を開くのに要る) |
CAP_NET_ADMIN | ネットワーク設定を変える(IP付与、ルーティング、firewall) |
CAP_SYS_ADMIN | マウントなど、大量の管理操作。実質 root |
CAP_SYS_TIME | システム時刻を変える |
CAP_CHOWN | ファイルの所有者を変える |
CAP_SYS_MODULE | カーネルモジュールを読み込む=カーネルに任意のコードを入れる |
Docker は、コンテナの root に対して、この束のうち一部しか渡しません。 既定では CAP_SYS_ADMIN も CAP_SYS_MODULE も渡していません。「root だが、できることは絞られている root」です。
個別に足すこともできます。
--privilegedを「動かないときのおまじない」にしないでください。--privilegedは、この束を全部渡し、さらにデバイスへのアクセス制限も外します。 その状態のコンテナの root は、ホストの root とほぼ同じです。カーネルモジュールを入れることも、ホストのディスクを直接読むこともできます。 「--privilegedを付けたら動いた」は、原因の特定ではありません。 足りない capability が1つあっただけのことが大半で、--cap-add=で1つだけ足すのが正解です。何が足りないかは、たいていエラーメッセージ(Operation not permitted)とドキュメントで分かります。 権限の回で「chmod 777は答えではない」と書いたのと、まったく同じ話です。通らないから全部開ける、をやらない。
コンテナの隔離は完全ではない
ここまで見てきたことを、正直にまとめます。
| 分けられているもの | 分けられていないもの |
|---|---|
| プロセス一覧(PID) | カーネルそのもの |
| ファイルシステムの見え方(Mount) | カーネルのバグ・脆弱性 |
| ネットワーク(Network) | ハードウェア |
| ホスト名(UTS) | 起動しているカーネルのバージョン・設定 |
| プロセス間通信(IPC) | 既定ではユーザーID(コンテナの root は UID 0 のまま) |
コンテナの隔離は「カーネルが見せている壁」です。 その壁を作っているカーネル自身に穴があれば、壁ごと抜けられます。
VMは違います。 ゲストのカーネルとホストのカーネルは別物で、間にハイパーバイザーというもう1枚の層があります。仮想化の回で見たとおりです。
だから、使い分けはこうなります。
| 状況 | 選ぶもの | 理由 |
|---|---|---|
| 自分が書いたアプリを分けて動かす | コンテナ | 速い・軽い・作り直しやすい |
| 同じチームの複数のサービスを1台に載せる | コンテナ | 隔離の強さより、扱いやすさが勝つ |
| 信用できない他人のコードを走らせる | VM | カーネルを共有したくない |
| 別のOS(Windows)が要る | VM | カーネルが違うので、そもそも不可能 |
| カーネルそのものを触る実験 | VM | 壊れても、そのVMだけで済む |
この記事の実験を「VMの中」でやってくださいと最初に書いた理由が、これです。
unshareも cgroups もホストのカーネルを直接触ります。 失敗しても VM ごと戻せる状態でやるのが、いちばん安全です。
つまずいたところ
順番に、実際に詰まったところを残します。
① unshare --pid だけでは PID 1 になれない
bash: fork: Cannot allocate memoryメモリ不足だと思って free -h を見ました。1.2GB 空いていました。 全然関係ありませんでした。
--fork を付けていなかっただけです。unshare を呼んだプロセス自身は新しい PID名前空間に入れないので、その中で fork しようとすると失敗します。エラーメッセージが実態を表していない典型でした。30分溶かしました。
② --mount-proc を忘れて「隔離できていない」と思った
PID: 1 と出ているのに ps に112個並ぶのを見て、「名前空間が効いていない」と結論しました。 効いていました。ps が古い /proc を読んでいただけです。
「ps はカーネルに聞いているのではなく /proc を数えている」 を知らなかったのが原因です。プロセスの回で /proc を触っていなければ、たぶん気づけませんでした。
③ メモリ上限を付けずに tail /dev/zero を打った
最初、cgroups の話に入る前に「メモリを食い潰すとどうなるか」を素で試しました。
VMが固まりました。 SSH の応答が返らなくなり、VMware の画面から強制電源断しました。スナップショットから戻しました。
上限なしで OOM を起こすと、何が殺されるかはカーネルが決めます。 sshd が選ばれると、もう入れません。 この記事で MemoryMax を先に説明してから tail /dev/zero を打っている順番には、この失敗が入っています。
④ MemorySwapMax=0 が無いと、なかなか死ななかった
MemoryMax=50M だけを付けたとき、tail は殺されずに、ただひたすら遅くなりました。
スワップに逃がしていたからです。cgroup v2 の MemoryMax は物理メモリの上限で、スワップは MemorySwapMax が別に持っています。 両方絞らないと、OOM には至りません。
スワップが無い環境では起きません。 確かめ方は、
⑤ /sys/fs/cgroup のパスを手で書き写して間違えた
記事で見たパス(/sys/fs/cgroup/docker/<id>/memory.max)をそのまま打って No such file or directory になりました。
Docker の cgroup ドライバの違いでした。パスを推測せず、/proc/<pid>/cgroup から読むのが確実です。この記事で CG=$(cut -d: -f3 /proc/$PID/cgroup) と書いているのは、そのためです。
⑥ ubuntu イメージの中で ps が無い
sh: 1: ps: not foundコンテナが壊れていると思いました。 入っていないだけでした。公式の ubuntu イメージはサイズを削るために procps を入れていません。 alpine は busybox に ps が含まれているので動きます。
「最小のイメージには、あなたが当然だと思っているコマンドが無い」——これは今後もずっと踏むと思います。
⑦ CPU制限が効いているか分からなかった
CPUQuota=50% を付けたのに、top で 100% 近く出ているように見えました。
見ていた列が %CPU の合計だったのと、nproc が 2 だったのが原因です。CPUが2個あるとき、top の %CPU は 200% まで出ます。 50% 制限は「2個のうち半分」ではなく「1個の半分」です。混乱したら nproc を先に見てください。
後片づけ
この記事で作ったものを、全部消します。
① 名前空間から抜ける
unshare で入ったシェルが残っていないか確認します。
bash が余分に出ていたら、そのターミナルで exit を打ってください。 プロセスが居なくなれば、名前空間は自動で消えます。
② ネットワーク名前空間を消す
何も出なければ消えています。
③ Docker のコンテナを消す
この記事で alpine イメージを取ってきています。 残しても数MBですが、消すなら、
④ 走っている systemd のユニットを止める
出てきたら止めます。
--scopeで作ったものは、コマンドが終われば自動で消えます。 残るのは--scopeを付けずに作った.serviceのほうだけです。
⑤ nginx の drop-in を戻したか確認する
MemoryMax=infinity
CPUQuotaPerSecUSec=infinity
infinity になっていれば、制限は外れています。 なっていなければ、
⑥ 作ったディレクトリを消す
⑦ 入れたパッケージ
libcap2-bin は残して構いません。 数百KBで、capsh と getcap はこの先も使います。
⑧ 全部片づいたか確認する
lsns の行数が最初とほぼ同じ(8〜10行程度)で、コンテナも netns も無ければ片づいています。
まとめ
- コンテナは「軽い仮想マシン」ではなく、カーネルの2つの機能の組み合わせ。 隔離=名前空間、制限=cgroups。Docker はこれを呼んでいるだけで、Docker 固有の魔法は無い
- 名前空間は7種類ある(PID / Mount / Network / UTS / IPC / User / Cgroup)。1つずつバラバラに作れる。
docker runはまとめて作っているだけ - 名前空間は「仮想化」ではなく「見える範囲の切り替え」。
uname -rは内側でも外側でも同じ値。カーネルは1つしかない unshare --pidには--forkが要る。 呼んだプロセス自身は新しい名前空間に入らない。エラーはCannot allocate memoryと出るが、メモリの問題ではない--mount-procを忘れると、PID 1 になっているのにpsにホストの全部が見える。psはカーネルではなく/procを数えているから。PIDの隔離とマウントの隔離はセット- マウント名前空間から抜けると、その中のマウントは消える。 「コンテナを消すとデータが消える」の正体。だから
-vでホスト側に置く - 新しいネットワーク名前空間には、機器が1つも無い。
loすらDOWN。外と繋ぐには線(veth)を挿す作業が要る。docker0とveth...がそれ - ネットワーク名前空間が別なら、同じポート番号を何個でも開ける。 コンテナで「ポート80が使用中」が起きない理由
- cgroup v2 は
/sys/fs/cgroupの下のただのファイル。MemoryMax=100Mはmemory.maxの104857600、CPUQuota=50%はcpu.maxの50000 100000 - メモリを食い潰す実験は、必ず上限を付けてからやる。 上限が無いと何が殺されるかカーネルが決める(
sshdが選ばれるとVMごと終わり) MemoryMaxだけではスワップに逃げて死なないことがある。MemorySwapMax=0とセットExited (137)は cgroups の OOM。137 = 128 + 9。SIGKILLなのでログも片づけも残らないMemoryMaxは「超えたら殺す」、MemoryHighは「超えたら苦しくする」。 落ちるより遅いほうがマシなサービスはMemoryHighsystemd-run -pに書けるものは、.serviceにもそのまま書ける。systemctl editの drop-in にMemoryMax=/CPUQuota=/TasksMax=docker run --memory=64m --cpus=0.5とsystemd-run -p MemoryMax=64M -p CPUQuota=50%は、cgroup のファイルとして1バイトも変わらない/sys/fs/cgroupのパスは推測しない。/proc/<pid>/cgroupから読む。Docker の cgroup ドライバで変わるdocker execでプロセスが2個しか見えないのは PID名前空間。 ホストのps -efには普通に並んでいる。隠れているだけで、消えてはいない- ホストから
/proc/<pid>/root/を見ると、コンテナの中身がそのまま読める - root は1つの権限ではなく、40個以上の capabilities の束。 Docker は既定で一部しか渡していない
--privilegedを「動かないときのおまじない」にしない。 束を全部渡す=ホストの root とほぼ同じ。足りない1つを--cap-add=で足すのが正解- コンテナの隔離は完全ではない。カーネルは共有している。 信用できないコード・別のOS・カーネルの実験は VM を使う
参考リンク
- roadmap.sh — Linux
- Ubuntu manpages — namespaces(7) 名前空間の全種類
- Ubuntu manpages — unshare(1)
- Ubuntu manpages — lsns(8)
- Ubuntu manpages — cgroups(7)
- Ubuntu manpages — capabilities(7) 全capabilityの一覧
- Ubuntu manpages — ip-netns(8)
- Ubuntu manpages — systemd-run(1)
- Linux カーネル公式 — Control Group v2
- systemd 公式 — systemd.resource-control 設定できる項目の一覧
- Docker 公式 — Resource constraints
- Docker 公式 — Runtime privilege and Linux capabilities
次に読む
この記事は 【深掘り】Linux の 16 / 18 本目です。
上から順に読めば積み上がるように並べています。 飛ばしても構いませんが、詰まったら前の回に戻ってください。
全体の順路は はじめに にあります。
roadmap.sh のどこをやっているか
- 名前空間(PID / Mount / Network / UTS)
- cgroups で CPU とメモリを制限する
この記事は、上の項目を実際に手を動かして確かめる回です。
コメント