※本記事はアフィリエイト広告(PR)を含みます。
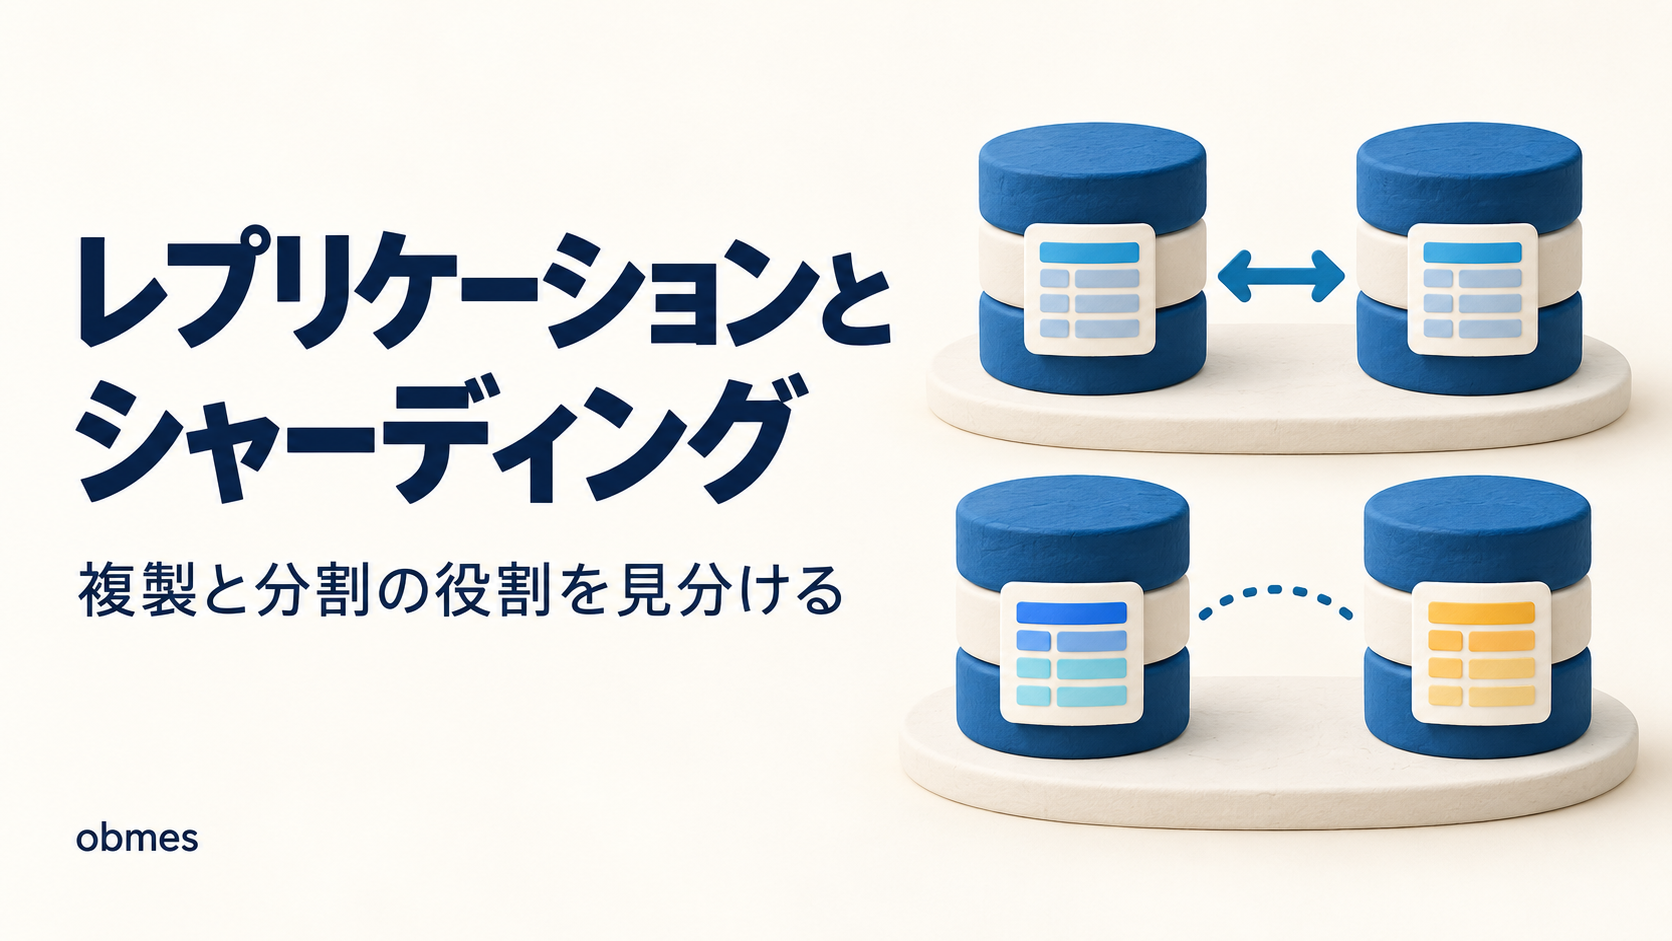
レプリケーションを増やしても、書き込みは速くなりません。シャーディングとの違いを押さえます。
これは【深掘り】の記事です。本線の順路ではありません。 読まなくても先へ進めます。 本線の書いた直後に読むと無い — レプリケーションとCAPの回の続きです。あの回では「複製には遅れがある」ところまでをやりました。この記事はその先です。「では、どう分ければ効くのか」を、全部手で動かして確かめます。
前回: 指数バックオフとバルクヘッド — リトライが障害を長引かせる
この記事のコマンドは、すべてVMの中(Ubuntu Server)で打ちます。 Windows の PowerShell では打ちません。
前提: VMに Docker と Docker Composeの書き方|複数コンテナをまとめて起動する が入っていること。
node -vが返ること。VMのメモリが 4GB以上あること(MySQL を最大3つ同時に起動します)。 端末を3つ開きます。 VS Code の統合ターミナルでも、sshを3本張っても構いません。以降「端末1」「端末2」「端末3」と呼びます。
対象レベル: 中級〜上級 / 区分: 発展
増やしたのに、1ミリ秒も速くならなかった
作っていた練習用のアプリで、書き込みが詰まりました。
投稿の保存に、ときどき2秒以上かかります。データベースは MySQL 1台です。「1台で足りないなら増やせばいい」と思いました。調べると「レプリケーション」という言葉が出てきます。MySQL を3台にして複製する。読んだ感じ、これで解決するように見えました。
半日かけて組みました。primary が1台、replica が2台。SHOW REPLICA STATUS も正常です。3台になりました。
書き込みは、1ミリ秒も速くなりませんでした。
当然です。あとから気づきました。
レプリケーションで増えるのは、コピーです。 書き込みを受け付ける口は、増えていません。
primary は1台のままです。INSERT も UPDATE も DELETE も、全部その1台に行きます。 replica は primary が書いた内容をあとから写しているだけで、replica に書くことはそもそも許されていません(あとで実際に怒られます)。
つまり、こうです。
| 増やしたもの | 分散するもの | 分散しないもの |
|---|---|---|
| レプリカ(複製) | 読み(SELECT) | 書き(INSERT / UPDATE / DELETE) |
私が詰まらせていたのは「書き」でした。 効く道具を、まったく別の問題に当てていたわけです。
では書きを分散するには何が要るのか。答えは 「データそのものを分ける」、つまりシャーディングです。ただしこれは、失うものがとても多い。 JOIN が消え、トランザクションが消え、採番が壊れます。
この記事では、その両方を実際に組んで、効くところと壊れるところを目で見ます。
この記事でわかること
- レプリケーションが分散するのは「読み」だけで、書きは primary 1台に集まったままだということ。増やす前に「詰まっているのは読みか書きか」を見ないと、半日が無駄になること
- レプリカを読むと、古い値が返りうること。しかもそれはエラーにならない。「遅延がある」ではなく「遅延している間、間違った答えを平然と返す」だということ
- primary が落ちても、レプリカは自分で昇格しないこと。昇格は人か、別の仕組みがやる。そして昇格したあとに古い primary を戻すと、書き込み口が2つになって壊れること
- ハッシュで分けると均等になるが、台数を1台増やしただけで75%のデータが引っ越すこと。一貫性ハッシュならそれが25%程度で済むこと。これを実際に数えて確かめる
- シャーディングすると JOIN とトランザクションが使えなくなること。AUTO_INCREMENT が衝突すること。集計が全台への問い合わせになること
- そして、シャーディングは最後の手段だということ。索引・キャッシュ・レプリカ・スケールアップを全部やってからでいいこと。個人サイトの規模では、まず要らないこと
この記事でやること
- MySQL を primary 1台 + replica 2台で実際に組み、複製が動いていることを
SHOW REPLICA STATUSで確かめる - 読みを replica に振り分けて、
docker statsとCom_selectで primary の負荷が実際に下がることを測る - わざと遅延を作り、遅れた replica を読むと古い値が返るところを再現する
- primary を停めて replica を昇格させ、そのあと古い primary を戻して二重書き込みを起こす
- 範囲・ハッシュ・一貫性ハッシュの3つの分け方を Node のスクリプトで計算し、台数を増やしたときの移動率を数えて比べる
- MySQL を2台に分けて JOIN・トランザクション・採番・集計が壊れるところを再現し、デノーマライズで直したうえで、判断表を作って全部消す
先に知る言葉
この記事で初めて出てくる言葉です。 基本的な言葉は用語集にもまとめてあります。
| 言葉 | 意味 |
|---|---|
| primary / replica | 書ける側が primary、写す側が replica。 昔は master / slave と呼ばれた。MySQL 8.0 では SHOW REPLICA STATUS のように新しい語に統一されている |
| GTID | 1つ1つの取引に付く世界で一意な番号。 これがあると「どこまで写したか」をファイル名と位置ではなく番号で言える |
| レプリケーション遅延(lag) | primary が書いてから replica に届くまでの遅れ。 Seconds_Behind_Source で見える |
| フェイルオーバー(failover) | primary が死んだとき、replica を新しい primary に切り替えること。 自動ではない |
| スプリットブレイン(split-brain) | 書ける primary が同時に2つ存在してしまう状態。 どちらも正しいつもりで書くので、あとで直せない |
| シャーディング(sharding) | データそのものを分けて、別のサーバーに置くこと。 「1〜100万番はA、100万1番からはB」のように分ける |
| シャードキー(shard key) | どの台に置くかを決めるための列。 一度決めると、あとから変えるのがとても難しい |
| ホットスポット | 分けたのに、特定の1台にだけ負荷が集中している状態。 分け方が悪いと起きる |
| 一貫性ハッシュ(consistent hashing) | 台数を増減しても、移動するデータが少なく済むように配置を決める方法。 負荷分散の回でも同じ考え方が出てくる |
| デノーマライズ(非正規化) | JOIN を減らすために、あえて同じ値を複数の表に持たせること。 正規化の逆をわざとやる |
⓪ 準備 —— 作業場所を作る
この記事は前の回の環境を汚しません。 専用のディレクトリを作って、そこで完結させます。
端末1で打ちます。
ディレクトリを2つに分けます。
| ディレクトリ | 使う場面 |
|---|---|
~/shardlab/repl | ①〜④のレプリケーション |
~/shardlab/shard | ⑤〜⑦のシャーディング |
同時に両方は起動しません。 MySQL は1つで 350〜450MB ほど使います。5台同時に立てるとVMのメモリが足りません。④が終わったら repl のほうを止めてから、shard に移ります。
まず、いま空いているメモリを見ておきます。
               total        used        free      shared  buff/cache   available
Mem:           3.8Gi       612Mi       2.6Gi        1.0Mi       684Mi       3.0Gi
available が 1.5Gi を下回っている場合は、他のコンテナを止めてから進めてください。
MySQL を 3 台同時に立てるので、手元の VM にメモリ 4GB を割けない場合は、期間を区切って VPS を借りる手もあります。シンVPS にはメモリあたりの月額を抑えた「大容量メモリプラン」があり、4GB プランは 1 ヶ月契約で月額 1,800 円(税込・2026-11 時点、2026 年 9 月 1 日の料金改定後)です。無料のお試し期間はなく、最低利用期間が 3 ヶ月ある点は借りる前に確かめてください。
① レプリケーションを実際に組む —— primary 1台 + replica 2台
compose.yaml を書く
以下を貼り付けます。
services:
  primary:
    image: mysql:8.0
    container_name: sl-primary
    command: >
      --server-id=1
      --log-bin=mysql-bin
      --gtid-mode=ON
      --enforce-gtid-consistency=ON
      --binlog-format=ROW
    environment:
      MYSQL_ROOT_PASSWORD: rootpass_change_me
      MYSQL_DATABASE: shop
    ports:
      - "127.0.0.1:3316:3306"

  replica1:
    image: mysql:8.0
    container_name: sl-replica1
    command: >
      --server-id=2
      --log-bin=mysql-bin
      --gtid-mode=ON
      --enforce-gtid-consistency=ON
      --binlog-format=ROW
      --read-only=ON
      --super-read-only=ON
    environment:
      MYSQL_ROOT_PASSWORD: rootpass_change_me
    ports:
      - "127.0.0.1:3317:3306"

  replica2:
    image: mysql:8.0
    container_name: sl-replica2
    command: >
      --server-id=3
      --log-bin=mysql-bin
      --gtid-mode=ON
      --enforce-gtid-consistency=ON
      --binlog-format=ROW
      --read-only=ON
      --super-read-only=ON
    environment:
      MYSQL_ROOT_PASSWORD: rootpass_change_me
    ports:
      - "127.0.0.1:3318:3306"
書いた内容の意味を、1行ずつ確認します。
| 設定 | 意味 |
|---|---|
--server-id | 3台で必ず別の数字にする。 同じだと複製が止まる |
--log-bin | バイナリログを書く。 primary には必須 |
--gtid-mode=ON | 取引に世界で一意な番号を振る。 これがあると繋ぎ直しが楽になる |
--binlog-format=ROW | 「どのSQLを実行したか」ではなく「どの行がどう変わったか」を記録する。 実行結果が環境で変わる関数を使っても、ずれない |
--read-only / --super-read-only | replica を書けなくする。 これを付けないと、うっかり replica に書けてしまう |
MYSQL_DATABASE: shop は primary にだけ書いています。 replica にも書くと、replica が自分で shop を作ってしまい、あとで GTID が食い違います(つまずいたところで詳しく書きます)。
ports の先頭に 127.0.0.1: が付いていることを必ず確認してください。 これが無いと、VMの外から誰でもデータベースに繋げます。
パスワードはそのまま使わないでください。 練習用でも変えます。以降この記事では rootpass_change_me と書きますが、変えたなら読み替えてください。
起動する
ホスト側のポートは、3台で必ず別の番号にします(3316 / 3317 / 3318)。同じ番号を2つ書くと port is already allocated で起動できません。
[+] Running 4/4
 ✔ Network repl_default  Created
 ✔ Container sl-primary   Started
 ✔ Container sl-replica1  Started
 ✔ Container sl-replica2  Started
MySQL は初回起動でデータベースを作るので、30〜60秒かかります。 待ってから確認します。
NAME          IMAGE       STATUS                    PORTS
sl-primary    mysql:8.0   Up 52 seconds (healthy)   127.0.0.1:3316->3306/tcp
sl-replica1   mysql:8.0   Up 52 seconds             127.0.0.1:3317->3306/tcp
sl-replica2   mysql:8.0   Up 52 seconds             127.0.0.1:3318->3306/tcp
中から生きているか確かめます。
mysqld is aliveAccess denied が出る場合は、まだ初期化中です。 30秒待ってからもう一度打ってください。
打つのを楽にする関数を作る
3台に対して何度も SQL を打ちます。 毎回長い行を書くと必ず打ち間違えます。
docker compose exec に -T を付けています。 付けないと対話用の端末を割り当てようとして、パイプで渡したときに出力が崩れます。
source は端末ごとに必要です。 端末2、端末3でも同じことをします。
primary 側に、複製用のユーザーを作る
エラーが出なければ成功です。 MySQL は成功したとき何も言いません。
mysql_native_password を指定しているのは、Node の mysql2 から繋ぐためです。 MySQL 8.0 の既定は caching_sha2_password で、そのままだと繋がらないことがあります。
replica 側の GTID をいったん空にする
ここが一番の落とし穴です。 replica は起動時に、自分で内部ユーザーなどを作っています。その分の GTID を持ったまま複製を始めると、「primary に無い取引を持っている」状態になり、繋がりません。
確認します。
executed
空欄になっていれば成功です。
replica を primary に繋ぐ
replica2 にも同じことをします。
SOURCE_HOST='primary' は、compose のサービス名です。 IPアドレスではありません。同じ compose の中なら、サービス名で引けます。
動いているか、目で確かめる
             Replica_IO_Running: Yes
            Replica_SQL_Running: Yes
          Seconds_Behind_Source: 0
                     Last_Error:
見るのはこの4つだけです。
| 項目 | 正常な値 | 意味 |
|---|---|---|
Replica_IO_Running | Yes | primary からログを受け取れている |
Replica_SQL_Running | Yes | 受け取ったログを自分に適用できている |
Seconds_Behind_Source | 0 | 遅れ(秒) |
Last_Error | 空 | 止まった理由 |
Replica_IO_Running: Connecting のまま止まる場合は、ユーザー名かパスワードか、SOURCE_HOST の綴りが違います。Last_IO_Error に理由が出ます。
📷 スクリーンショット①: Replica_IO_Running: Yes / Replica_SQL_Running: Yes / Seconds_Behind_Source: 0 が並んだ画面。ここが「組めた」の証拠なので、必ず撮っておきます。
本当に複製されているか、書いて確かめる
設定が正しいことと、複製が動いていることは別です。実際に書きます。
replica 側で読みます。
id	name	note
1	first	hello
id	name	note
1	first	hello
両方に届いています。 CREATE TABLE(表の定義)も複製されている点に注目してください。データだけでなく、構造の変更も流れます。
replica に書こうとすると、どうなるか
ERROR 1290 (HY000) at line 1: The MySQL server is running with the --super-read-only option so it cannot execute this statementこれが「書きは分散しない」の正体です。 replica は物理的に書けません。レプリカを2台足しても、書き込み口は最初から最後まで1つです。
200,000行を用意する
負荷を測るためのデータを入れます。
30秒ほどかかります。
SET SESSION cte_max_recursion_depth を入れないと、1000行で止まります。 MySQL の既定の再帰上限が1000だからです。
ERROR 3636 (HY000): Recursive query aborted after 1001 iterations.行数を確認します。
COUNT(*)
200000
COUNT(*)
200000
20万行が、両方に届いています。
② 読みを replica に振る —— 何が下がるのかを実測する
測るための道具を入れる
added 12 packages in 2s負荷をかけるスクリプトを書く
const mysql = require('mysql2/promise');

const PORTS = { primary: 3316, replica1: 3317, replica2: 3318 };
const MODE = process.argv[2] || 'primary-only';
const TOTAL = 600;
const CONC = 30;

// わざと重いクエリ。索引を使えないので毎回20万行を読む
const HEAVY = "SELECT COUNT(*) FROM items WHERE note LIKE '%9ab%'";

async function pools() {
  const p = {};
  for (const [name, port] of Object.entries(PORTS)) {
    p[name] = await mysql.createPool({
      host: '127.0.0.1', port, user: 'app', password: 'app_change_me',
      database: 'shop', connectionLimit: CONC, waitForConnections: true,
    });
  }
  return p;
}

async function comSelect(pool) {
  const [rows] = await pool.query("SHOW GLOBAL STATUS LIKE 'Com_select'");
  return Number(rows[0].Value);
}

(async () => {
  const p = await pools();
  const names = Object.keys(PORTS);

  const before = {};
  for (const n of names) before[n] = await comSelect(p[n]);

  // 振り分け先を決める
  const targets = [];
  for (let i = 0; i < TOTAL; i++) {
    if (MODE === 'primary-only') targets.push('primary');
    else targets.push(names[i % names.length]);   // 順番に3台へ
  }

  const t0 = Date.now();
  let idx = 0;
  await Promise.all(Array.from({ length: CONC }, async () => {
    while (idx < targets.length) {
      const my = targets[idx++];
      await p[my].query(HEAVY);
    }
  }));
  const ms = Date.now() - t0;

  const after = {};
  for (const n of names) after[n] = await comSelect(p[n]);

  console.log(`mode=${MODE}  ${TOTAL}件  ${ms} ms`);
  for (const n of names) {
    console.log(`  ${n.padEnd(9)} Com_select +${after[n] - before[n]}`);
  }
  for (const n of names) await p[n].end();
})();
まず、全部 primary に投げる
端末2を開き、docker stats を出しておきます。
端末1で実行します。
mode=primary-only  600件  24180 ms
  primary   Com_select +603
  replica1  Com_select +2
  replica2  Com_select +2
端末2の docker stats は、実行中こうなります。
CONTAINER     CPU %     MEM USAGE / LIMIT
sl-primary    291.40%   468.2MiB / 3.8GiB
sl-replica1     0.31%   402.1MiB / 3.8GiB
sl-replica2     0.28%   401.7MiB / 3.8GiB
primary だけが 291% で、replica は寝ています。 2台足したのに、1台も働いていません。
📷 スクリーンショット②: この docker stats の画面。「増やしたのに使われていない」が、数字で見えているところです。
次に、3台へ順番に振る
mode=round-robin  600件  22960 ms
  primary   Com_select +203
  replica1  Com_select +202
  replica2  Com_select +202
CONTAINER CPU % MEM USAGE / LIMIT
sl-primary 99.80% 470.9MiB / 3.8GiB
sl-replica1 96.12% 448.3MiB / 3.8GiB
sl-replica2 97.55% 447.0MiB / 3.8GiBprimary の CPU が 291% → 99% に落ちました。 読みは確かに3等分されています。
ところが、総時間はほとんど変わっていない
24180 ms → 22960 ms。5%です。 3台にしたのに、3倍にはなりません。
理由は、私の測り方にあります。
3台とも、同じVMの中の、同じCPUで動いているからです。
コンテナを3つに分けても、計算する装置は1つです。仕事を3つの箱に分けただけで、箱を動かす人は変わっていません。分散の効果が出るのは、CPUが別々のときだけです。
ここで測れたのは「速くなった」ではありません。 測れたのはこれです。
primary が背負っていた読みの仕事を、外に出せた。
それの何が嬉しいのか。 primary は書き込みを受ける唯一の台です。その台が読みで 291% 使い切っていたら、書き込みが待たされます。 読みを外に出せば、primary は書き込みに専念できます。
「速くなる」ではなく「詰まらなくなる」。 レプリカを足す本当の効き目は、こちらです。
本番でこれを確かめるときは、必ず別のマシンに置いてください。 同じマシンに並べて「効かなかった」と結論すると、間違った学習をします。私は最初これで「レプリケーションは効かない」と思いました。
③ わざと遅延を作る —— 古い値が、エラーも出さずに返る
まず、正直な方法で遅らせてみる
primary に一気に大量の書き込みをします。
別の端末(端末3)で、遅れを見張ります。
          Seconds_Behind_Source: 0
          Seconds_Behind_Source: 0
          Seconds_Behind_Source: 3
          Seconds_Behind_Source: 6
          Seconds_Behind_Source: 5
          Seconds_Behind_Source: 1
          Seconds_Behind_Source: 0
6秒まで遅れて、戻りました。 Ctrl + C で止めます。
📷 スクリーンショット③: Seconds_Behind_Source が 0 から増えて、また 0 に戻っていく画面。「遅延は常にあるのではなく、山として来る」ことが分かります。
遅延を、確実に再現できる形にする
上の方法は、VMの速さによっては一瞬で終わってしまいます。 確実に見たいので、わざと10秒遅らせる設定を使います。
これは MySQL の正式な機能です。 「replica を意図的に遅らせる」設定で、本番では誤った DELETE から復旧するための保険として使われます。
書いた直後に、replica を読む
何も返りません。 エラーではありません。「そんな行はありません」という、正しい形の間違った答えです。
10秒待ってから、もう一度読みます。
id	name	note
999999	newest	just-written
今度は返りました。
ここが、この記事で一番危ないところ
アプリ側から見ると、こうなります。
| 手順 | 利用者に見えること |
|---|---|
| 1. 利用者がプロフィールを更新(primary に書く) | 「保存しました」 |
| 2. 画面が再読み込み(replica から読む) | 古い名前が表示される |
| 3. 利用者がもう一度更新 | 同じ操作を2回やることになる |
エラーログには何も出ません。 アプリも落ちません。「たまに保存されない」という、再現しない不具合として現れます。
前回までの記事で扱った更新したのに古い値が返る — システム設計深掘りと、まったく同じ形の問題です。キャッシュが古いのも、レプリカが古いのも、原因は「コピーがある」ことです。
対策は3つです。
| 対策 | やること | 代償 |
|---|---|---|
| 書いた直後だけ primary を読む | 「自分が書いたものは自分には見える」を守る(read-your-writes) | アプリ側にその判断を書く必要がある |
| セッション単位で primary に固定する | ログイン中の人は一定時間 primary を読む | 分散の効果が薄れる |
| 遅延が閾値を超えた replica を、振り分け先から外す | 監視して自動で外す | 仕組みが増える |
「遅延をゼロにする」は選択肢に入っていません。 ネットワークがある以上、遅延は消えないからです。
遅延の設定を戻す
④ フェイルオーバーの現実 —— 誰も自動では昇格しない
primary を止める
[+] Stopping 1/1
 ✔ Container sl-primary  Stopped
replica の状態を見ます。
             Replica_IO_Running: Connecting
            Replica_SQL_Running: Yes
                  Last_IO_Error: error reconnecting to source 'repl@primary:3306' - retry-time: 60 retries: 1 message: Unknown MySQL server host 'primary'
Connecting のまま、60秒ごとに再試行し続けます。 replica はずっと待ちます。
replica は、自分から primary になることは絶対にない
読みは、まだ動きます。
COUNT(*)
200001
書きは、できません。
ERROR 1290 (HY000): The MySQL server is running with the --super-read-only option so it cannot execute this statementprimary が死んだ瞬間、システムは「読めるが書けない」状態になります。 そして、放っておけば永遠にその状態のままです。
「レプリカがあるから大丈夫」は、ここまでしか意味しません。 大丈夫なのはデータが消えないことだけで、サービスが続くことは保証されていません。
手で昇格させる
replica1 を新しい primary にします。
書けるようになったか確かめます。
id	name	note
1000001	after-promote	written-on-replica1
昇格できました。 打ったのは私です。 MySQL は何もしてくれませんでした。
replica2 を、新しい primary に繋ぎ替える
replica2 はまだ、死んだ primary を見ています。 向きを変えます。
repl ユーザーは replica1 にも複製されていたので、そのまま使えます。 複製されていなければ、ここで作り直しになります。
id	name	note
1000001	after-promote	written-on-replica1
新しい primary から、届きました。
古い primary を、そのまま戻すとどうなるか
ここが本題です。
古い primary は、自分がまだ primary だと思っています。 そして read_only は付いていません。つまり、書けます。
エラーは出ません。 成功します。
いま、何が起きているか見ます。
id	name	note
1000001	zombie	written-on-OLD-primary
id	name	note
1000001	after-promote	written-on-replica1
同じ主キーの行が、2台で別の中身になりました。
これがスプリットブレインです。 どちらも「自分が正しい」と思っていて、どちらを捨てるかを機械は決められません。人が中身を見て、業務的に判断するしかありません。
さらに、繋ぎ直そうとすると、こうなります。
             Replica_IO_Running: No
                  Last_IO_Error: Got fatal error 1236 from source when reading data from binary log: 'Cannot replicate because the source purged required binary logs. / The GTID set sent by the replica is not a subset of the source'
GTID が食い違っているので、繋がりません。 古い primary が独自に作った取引(zombie の行)が、新しい primary には存在しないからです。
GTID があってよかった、とも言えます。 これが無い設定なら、繋がってしまい、静かにデータが壊れます。
昇格でやるべきことの順番
実際にやってみて分かった、正しい順番です。
| 順 | やること | やらないと |
|---|---|---|
| 1 | 古い primary を確実に殺す(電源・ネットワークごと) | 二重書き込みになる |
| 2 | どの replica が一番進んでいるか調べる(gtid_executed を比べる) | 遅れた台を昇格させて、書き込みが消える |
| 3 | その replica を昇格させる | — |
| 4 | 残りの replica を、新しい primary に向け直す | 古い primary を見続けて止まる |
| 5 | アプリの接続先を切り替える | 昇格しても誰も繋がない |
| 6 | 古い台は、繋ぎ直さず作り直す | GTID が食い違って入らない |
手順1が最初にある理由が、いま分かったはずです。
本番でこれを手作業でやる想定は、現実的ではありません。 深夜に起きて6手順を間違えずに打つのは無理です。だから Orchestrator、MHA、Group Replication、クラウドのマネージドDBといった自動化の仕組みがあります。この記事の意義は、その自動化が「何を代わりにやってくれているか」が分かることです。
⑤ 型を比べる —— primary は何台まで許されるか
手を動かしたところで、形を整理します。
| 型 | 書ける台 | 衝突の解決 | 遅延 | 向いている場面 |
|---|---|---|---|---|
| 単一 primary(source-replica) | 1台 | 起きない | あり | ほとんどの場合これ。 読みが多いアプリ |
| 複数 primary(multi-source / 双方向) | 2台以上 | 自分で解く | あり | 地域ごとに書きたい、拠点間で相互に写したい |
| グループレプリケーション(Group Replication) | 設定次第 | 仕組みが多数決で決める | あり | 自動フェイルオーバーが要る |
複数 primary は「書きを分散する方法」ではない
ここを勘違いしていました。 primary が2台あれば書きが2倍になる、と思ったからです。違います。
東京とニューヨークに1台ずつ primary を置いて、双方向に複製する構成を考えます。 同じ瞬間に、こうなったとします。
| 場所 | やったこと |
|---|---|
| 東京 | UPDATE users SET name='田中' WHERE id=1 |
| ニューヨーク | UPDATE users SET name='Tanaka' WHERE id=1 |
どちらも成功します。 そして、お互いに複製が届きます。
nameは、何になるべきでしょうか。
答えはありません。 データベースには決められません。決め方を用意するのは、あなたです。
| 決め方 | 内容 | 問題 |
|---|---|---|
| 最後に書いたほうが勝つ(LWW) | タイムスタンプが新しいほうを採用 | 時計がずれていたら、古いほうが勝つ。負けた側の更新は消える |
| 列ごとに勝者を決める | 「名前は東京優先、住所はNY優先」 | 業務ごとに設計が要る |
| そもそも衝突させない | 利用者ごとに、書く台を固定する | これが実質の正解。ただしもうシャーディングです |
3つ目に注目してください。 「衝突させない」まで持っていくと、それは「データを分けている」ということです。つまり——
書きを本当に分散したければ、行き着く先はシャーディングです。
グループレプリケーションは、単一 primary モードで使うのが基本です。 自動で昇格してくれる(④の6手順を代わりにやってくれる)ことが主な価値で、書きを増やす道具ではありません。
⑥ シャーディング —— 分け方を3つ、実際に計算して比べる
ここからは MySQL をいったん離れて、紙の上の話を数字にします。 分け方の良し悪しは、「台数を変えたときに、何%のデータが引っ越すか」で決まります。
レプリケーションの環境を止める
[+] Running 4/4
 ✔ Container sl-primary   Removed
 ✔ Container sl-replica1  Removed
 ✔ Container sl-replica2  Removed
 ✔ Network repl_default   Removed
-v を付けているので、中のデータごと消えます。 ④までの内容を見返したい場合は、消す前にメモしておいてください。
メモリが戻っていることを確認します。
計算用のディレクトリを作る
分け方1: 範囲で分ける(レンジ)
// 100万件のIDを「範囲」で3台に分ける
const NODES = 3;
const TOTAL = 1000000;
const PER = Math.ceil(TOTAL / NODES);

const place = id => Math.min(Math.floor((id - 1) / PER), NODES - 1);

// 1) 均等に見えるか
const count = new Array(NODES).fill(0);
for (let id = 1; id <= TOTAL; id++) count[place(id)]++;
console.log('全体の分布:', count);

// 2) 「直近10万件」がどこにいるか
const recent = new Array(NODES).fill(0);
for (let id = TOTAL - 99999; id <= TOTAL; id++) recent[place(id)]++;
console.log('直近10万件:', recent);全体の分布: [ 333334, 333334, 333332 ]
直近10万件: [ 0, 0, 100000 ]1行目だけ見ると、完璧に均等です。 2行目が問題です。
新しく作られるデータは、100%が最後の1台に行きます。
アプリの読み書きは、たいてい新しいデータに集中します。 直近1週間の投稿、今日の注文、最近のログイン。それが全部1台に載ります。
これがホットスポットです。 3台に分けたのに、忙しいのは1台だけ。残り2台は古いデータを抱えて寝ています。
範囲分割は「捨てるのが楽」という利点があります。 「2024年のデータは丸ごとこの台なので、台ごと消せる」。時系列のログのように、古いものを定期的に捨てる用途では、これが正解になります。
分け方2: ハッシュ(剰余)で分ける
// id % N で分ける。台数を3→4にすると何%が引っ越すか
const TOTAL = 1000000;

function dist(n) {
  const c = new Array(n).fill(0);
  for (let id = 1; id <= TOTAL; id++) c[id % n]++;
  return c;
}

console.log('3台の分布:', dist(3));
console.log('4台の分布:', dist(4));

let moved = 0;
for (let id = 1; id <= TOTAL; id++) {
  if (id % 3 !== id % 4) moved++;
}
console.log(`3台 → 4台 で引っ越す件数: ${moved} (${(moved / TOTAL * 100).toFixed(1)}%)`);3台の分布: [ 333333, 333334, 333333 ]
4台の分布: [ 250000, 250000, 250000, 250000 ]
3台 → 4台 で引っ越す件数: 750000 (75.0%)分布は完璧です。 新しいデータも、古いデータも、均等に散ります。ホットスポットは消えました。
ところが、台を1台足しただけで75%が引っ越します。
なぜ75%なのか。 id % 3 と id % 4 が一致するのは、12件に3件だけです。手で確かめられます。
| id | id % 3 | id % 4 | 同じか |
|---|---|---|---|
| 0 | 0 | 0 | ○ |
| 1 | 1 | 1 | ○ |
| 2 | 2 | 2 | ○ |
| 3 | 0 | 3 | × |
| 4 | 1 | 0 | × |
| 5 | 2 | 1 | × |
| 6 | 0 | 2 | × |
| 7 | 1 | 3 | × |
12件のうち3件、つまり25%だけが残り、75%が動きます。
これは「データベースを1台増やす作業」ではありません。 全データの4分の3を、サービスを動かしたまま、別の台へ移す作業です。
1TBあれば750GBが動きます。 動いている間、どちらの台を読めばいいのかも問題になります。
分け方3: 一貫性ハッシュ
「台数が変わっても、移動を少なくしたい」という問題に対する答えです。
考え方はこうです。
- 0 から 42億くらいまでの数直線を、輪っかにする(端が繋がっている)
- 台の名前をハッシュして、輪の上に点を打つ(1台につき何百個も打つ = 仮想ノード)
- データのキーもハッシュして、輪の上に置く
- そこから時計回りに進んで、最初に出会った点の台に入れる
台を1台足すと、輪の上に新しい点が増えます。 すると、その点の直前の区間にいたデータだけが引っ越します。他の区間は、まったく影響を受けません。
const crypto = require('crypto');

// 分布を決めるためだけのハッシュ。暗号用途ではない
const h = s => crypto.createHash('md5').update(String(s)).digest().readUInt32BE(0);

function buildRing(nodes, vnodes) {
  const ring = [];
  for (const n of nodes) {
    for (let i = 0; i < vnodes; i++) ring.push({ hash: h(`${n}#${i}`), node: n });
  }
  ring.sort((a, b) => a.hash - b.hash);
  return ring;
}

// 時計回りに最初に出会う点を探す(二分探索)
function lookup(ring, key) {
  const kh = h(key);
  let lo = 0, hi = ring.length - 1;
  if (kh > ring[hi].hash) return ring[0].node;
  while (lo < hi) {
    const mid = (lo + hi) >> 1;
    if (ring[mid].hash < kh) lo = mid + 1; else hi = mid;
  }
  return ring[lo].node;
}

const VNODES = Number(process.argv[2] || 200);
const TOTAL = 200000;

const ring3 = buildRing(['db-a', 'db-b', 'db-c'], VNODES);
const ring4 = buildRing(['db-a', 'db-b', 'db-c', 'db-d'], VNODES);

const c3 = {}, c4 = {};
let moved = 0;

for (let id = 1; id <= TOTAL; id++) {
  const a = lookup(ring3, `user:${id}`);
  const b = lookup(ring4, `user:${id}`);
  c3[a] = (c3[a] || 0) + 1;
  c4[b] = (c4[b] || 0) + 1;
  if (a !== b) moved++;
}

console.log(`仮想ノード数: ${VNODES}`);
console.log('3台の分布:', c3);
console.log('4台の分布:', c4);
console.log(`3台 → 4台 で引っ越す件数: ${moved} (${(moved / TOTAL * 100).toFixed(1)}%)`);仮想ノード数: 200
3台の分布: { 'db-b': 66015, 'db-a': 68344, 'db-c': 65641 }
4台の分布: { 'db-b': 49712, 'db-d': 50893, 'db-a': 50201, 'db-c': 49194 }
3台 → 4台 で引っ越す件数: 50893 (25.4%)75.0% が 25.4% になりました。
📷 スクリーンショット④: modulo.js と hashring.js の出力を並べた画面。75.0% と 25.4% が並んでいるのが要点です。
そして、25.4% という数字には意味があります。
引っ越したのは、新しく入った db-d が受け持つ分だけです。 出力を見ると db-d は 50893 件を持っていて、引っ越し件数と完全に一致しています。 つまり——
既にある3台の間では、1件も動いていません。
これが一貫性ハッシュの効き目です。 移動するのは「新しい台が引き受ける分」だけで、それは理論上 1/(台数) になります。4台なら25%です。
仮想ノードを減らすと、偏る
vnodes の数を変えて試します。
仮想ノード数: 1
3台の分布: { 'db-a': 12277, 'db-b': 155603, 'db-c': 32120 }
...
仮想ノード数: 10
3台の分布: { 'db-a': 51197, 'db-b': 88410, 'db-c': 60393 }
...
仮想ノード数: 500
3台の分布: { 'db-a': 67789, 'db-b': 66103, 'db-c': 66108 }仮想ノードが1個だと、db-b が全体の78%を持っています。 輪の上に3点しか打っていないので、区間の長さがバラバラになるからです。
仮想ノードは、その偏りをならすための仕掛けです。 100〜500くらい打つのが普通です。
同じ考え方は、3台に振り分けたのに偏る — システム設計深掘りでも出てきました。 ロードバランサでも分散キャッシュでも、「増減に強い割り当て」が要るところには必ずこれが出てきます。
3つを並べる
| 分け方 | 分布 | 台を1台増やしたときの移動 | 範囲検索 | 弱点 |
|---|---|---|---|---|
| 範囲 | 見た目は均等 | 境界だけ変えれば少ない | できる(id BETWEEN が1台で済む) | 新しいデータが1台に偏る |
| 剰余ハッシュ | 均等 | 75%が引っ越す | できない(全台に聞く) | 増設が事実上不可能 |
| 一貫性ハッシュ | 均等(仮想ノードが必要) | 25%程度 | できない | 仕組みが複雑。自前実装は割に合わない |
「一貫性ハッシュが正解」ではありません。 時系列ログのように古いものを丸ごと捨てる用途なら、範囲分割のほうが圧倒的に楽です。捨てやすさも設計項目です。
⑦ シャーディングで失うもの —— 2台に分けて、実際に壊す
ここからまた MySQL を使います。今度は2台です。
2台立てる
services:
  shard0:
    image: mysql:8.0
    container_name: sl-shard0
    environment:
      MYSQL_ROOT_PASSWORD: rootpass_change_me
      MYSQL_DATABASE: shop
    ports:
      - "127.0.0.1:3326:3306"

  shard1:
    image: mysql:8.0
    container_name: sl-shard1
    environment:
      MYSQL_ROOT_PASSWORD: rootpass_change_me
      MYSQL_DATABASE: shop
    ports:
      - "127.0.0.1:3327:3306"
複製はしません。 シャードは互いに別のデータを持ちます。ここが根本的に違うところです。
表を作り、user_id % 2 で分けて入れる
利用者を4人、id % 2 で振り分けます。
注文も、user_id % 2 で同じ台に置きます。
失うもの 1: 台をまたぐ JOIN
同じ台に載っているものは、JOIN できます。
name	amount
佐藤	1200
佐藤	800
鈴木	3000
では、全利用者の注文一覧は?
2回打って、目で足すしかありません。 shard0 の MySQL は、shard1 の存在を知りません。
「同じ台に載せる」ことを設計で担保したから、上の JOIN は動きました。 これを コロケーション(co-location) と言います。
もし orders を order_id % 2 で分けていたら、どうなるか。 その場合、佐藤さんの注文は shard0 と shard1 に散らばります。JOIN は、1つの台の中でも完結しません。
シャードキーを何にするかは、「どのクエリを1台で完結させたいか」で決まります。 あとから変えるのは、全データの引っ越しです。
JOINは表を繋いでいない — SQL深掘りで見たとおり、JOIN は「同じメモリ空間にある2つの集合」を組み合わせる操作です。 集合が別のマシンにあれば、成立しません。
失うもの 2: 台をまたぐトランザクション
佐藤さん(shard0)から田中さん(shard1)へ、1000円を移します。
2つとも成功すれば、問題ありません。 問題は、間で落ちたときです。
やってみます。1つ目を実行し、2つ目の前に shard1 を落とします。
service "shard1" is not runningSUM(amount)
-4000
SUM(amount)
15005000円が、この世から消えました。
佐藤さんからは引かれ、田中さんには入っていません。 そして、どちらの MySQL も「トランザクションは成功した」と思っています。
全部やるか、1つもやらないか — トランザクションとACIDで見た原子性は、1つのデータベースの中でしか成立しません。
回避の道は3つあります。
| 方法 | 内容 | 代償 |
|---|---|---|
| そもそもまたがせない | 1つの取引に関わるデータを、同じシャードに置く | シャードキーの設計がすべて |
| サガ(Saga) | 各段階を順に実行し、失敗したら打ち消す処理を流す | 打ち消し処理を全部書く。中間状態が見える |
| 2相コミット(2PC) | 全台に「準備できたか」を聞いてから確定する | 遅い。1台が固まると全部止まる |
1つ目が圧倒的に正しい選択です。 「またぐ設計にしない」が、シャーディングの設計そのものです。
失うもの 3: 採番が衝突する
orders.id は両方の台で AUTO_INCREMENT です。何が入っているか見ます。
id	user_id
1	2
2	2
3	4
4	2
5	2
id	user_id
1	1
2	3
3	1
id=1の注文が、2つあります。
id=1 の注文を見せてください、と言われたら、どちらを返せばいいのか分かりません。 単独の台では主キーでも、システム全体では主キーになっていません。
対策は3つです。
| 方法 | やり方 | 長所 | 短所 |
|---|---|---|---|
| オフセットをずらす | shard0 は奇数、shard1 は偶数を採番する | すぐできる | 台を増やすと破綻する |
| UUID | ランダムな128bitを使う | 台を増やしても衝突しない | 順序がバラバラなので、主キー索引が断片化して遅くなる |
| スノーフレーク方式 | 「時刻 + 台番号 + 連番」を1つの整数に詰める | 時刻順に増えるので索引が効く | 仕組みを持つ必要がある。時計のずれに弱い |
1つ目を実際にやってみます。
ここでハマりました。 設定はセッション開始時に読まれるので、既に開いている接続には効きません。 繋ぎ直します。
id	user_id
1	2
3	4
id	user_id
2	1
4	3
衝突しなくなりました。 shard0 が奇数、shard1 が偶数です。
ただし、これは2台専用です。 3台目を足した瞬間、auto_increment_increment を3にする必要があり、既存のIDと衝突します。 ⑥で見た「剰余は増設に弱い」と、まったく同じ構造の問題です。
UUID がなぜ遅くなるかは、索引を張ったのに使われない — SQL深掘りで見た B-tree の形を思い出すと分かります。 ランダムな値を主キーにすると、挿入位置が毎回バラバラになり、ページの分割が多発します。
失うもの 4: 集計が、全台への問い合わせになる
「全注文の合計金額」を出します。
SUM(amount)
300
SUM(amount)
700
アプリ側で足して 1000 です。 SUM は足せます。COUNT も MAX も MIN も足せます。
足せないものがあります。
| 集計 | 全台の結果から出せるか |
|---|---|
COUNT / SUM / MAX / MIN | 出せる |
AVG | 平均の平均は平均ではない。 SUM と COUNT を別々に集めて割る |
| 全体の中央値 | 出せない。 全データを1箇所に集めるしかない |
| 全体で金額上位10件 | 各台から10件ずつ取って、手元で並べ直せば出せる |
全体の COUNT(DISTINCT user_id) | 出せない。 重複を除くには、値そのものを集める必要がある |
そして、台が100台あれば100回問い合わせます。 一番遅い1台が、全体の応答時間になります。
「管理画面の集計が重い」は、シャーディングした環境で必ず起きます。 対策は集計専用の場所を別に持つことです。夜間に1箇所へ集めた分析用のデータベースを作る、というのが定番です。
⑧ デノーマライズ —— JOIN できないなら、持たせておく
⑦で JOIN が使えなくなりました。 これに対する、実務でよく使う逃げ道です。
考え方は、身も蓋もありません。
JOIN が要るのは、片方にしか値が無いからです。 両方に持たせておけば、JOIN は要りません。
orders に、利用者名を最初から入れておきます。
これで、users を見ずに注文一覧が作れます。
id	user_name	amount
1	佐藤	100
3	鈴木	200
JOIN が消えました。 シャードをまたいでも、注文の表だけ見れば画面が作れます。
その代わりに、何を失ったか
佐藤さんが改名しました。
id	user_name
1	佐藤
注文の中の名前は、古いままです。 データベースは、勝手に直してくれません。
正規化は「同じ値を2箇所に持たない」という約束でした。 デノーマライズは、その約束を、意図的に破ることです。
破った以上、整合性を保つ責任はアプリに移ります。
| 方法 | 内容 | 注意 |
|---|---|---|
| 書くときに両方直す | users を更新したら、その人の orders も更新する | 台をまたぐので、⑦の「トランザクションが無い」問題に戻る |
| 非同期で追いかける | 更新イベントをキューに流し、後から直す | 一時的にずれる(結果整合性) |
| そもそも直さない | 「注文時点の名前」として、わざと固定する | これが正しい場合が多い |
3つ目に注目してください。 領収書に書く宛名は、注文したときの名前であるべきです。あとから改名しても、過去の領収書の宛名は変わりません。
「重複しているから直すべき」ではなく、「その値は、いつの時点のものか」を先に決めます。
時点を固定すべき値なら、デノーマライズは妥協ではなく、正しい設計です。
⑨ 判断表 —— シャーディングは最後の手段
ここまでやって、はっきりしたことがあります。
シャーディングで失うものは、大きすぎます。 JOIN、トランザクション、一意なID、集計。それらは全部、無料で使えていた便利さでした。
だから、順番があります。上から試して、効かなかったら次に進みます。
| 順 | 手 | 効くもの | どこまで伸びるか | 失うもの |
|---|---|---|---|---|
| 1 | 索引を張る(SQL深掘り) | 読み | 1000倍になることがある | 書き込みが少し遅くなる |
| 2 | 遅いクエリを直す(N+1をやめる) | 読み・書き | 数倍〜数十倍 | なし |
| 3 | キャッシュを置く(キャッシュの回) | 読み | 数十倍 | 古い値が返りうる |
| 4 | 1台を強くする(スケールアップ) | 読み・書き両方 | CPU 64コア / メモリ1TB くらいまで | お金。1台が落ちたら全部止まる |
| 5 | 読みをレプリカへ(この記事の①〜③) | 読みだけ | 読みは台数分 | 遅延。フェイルオーバーの運用 |
| 6 | 機能で分ける(垂直分割) | 読み・書き | 機能の数だけ | その境界を越える JOIN が消える |
| 7 | シャーディング(この記事の⑥〜⑧) | 書きも含めて全部 | 理論上いくらでも | JOIN・トランザクション・採番・集計 |
手4「1台を強くする」を飛ばす人が多い、というのが一番の学びでした。
「スケールアップは限界がある」と本には書いてあります。事実です。しかしその限界は、思っているよりずっと高いです。数百万件の投稿があるサイトでも、まともに索引が張られていれば1台で動きます。
手7に進んでよいのは、こういうときだけです。
| 判断 | 内容 |
|---|---|
| 書き込みが、1台の性能上限に本当に達している | 測ってあること。 「重い気がする」ではない |
| データ量が、1台のディスクに収まらない | 数TB規模 |
| 手1〜6を、全部やり終えている | 索引もキャッシュも、レプリカもやった |
| シャードキーを、業務から決められる | 「利用者ごと」のように、またがない切り口があること |
4つ目が満たせないなら、シャーディングしてはいけません。 またぐ問い合わせだらけの構成は、分ける前より遅くなります。
個人サイトでは、まず要らない
この記事で組んだものを、自分のサイトに入れる必要はありません。
| 規模 | 必要なもの |
|---|---|
| 個人サイト・練習用 | 1台。索引だけ張る |
| 日に数万アクセス | 1台 + キャッシュ |
| 読みが重くなってきた | レプリカ1台(この記事の①〜③) |
| 書きが1台に収まらない | そこで初めてシャーディング |
それでも組んでみる価値はあります。 ④のフェイルオーバーを一度手で通しておくと、マネージドDBが月額いくらで何を代わりにやっているのかが分かるようになります。私はこれをやったあと、マネージドDBの値段が急に安く見えました。
つまずいたところ
1. replica にも MYSQL_DATABASE を書いて、複製が始まらなかった
最初、3台とも MYSQL_DATABASE: shop を書いていました。 START REPLICA すると、こうなりました。
Last_Error: Error 'Can't create database 'shop'; database exists' on query. Default database: 'shop'. Query: 'CREATE DATABASE shop'replica が起動時に自分で shop を作っていたので、primary から来た CREATE DATABASE が失敗したわけです。
MYSQL_DATABASE は primary にだけ書きます。 データベースの作成も、複製で流れてきます。
2. RESET MASTER を忘れて、GTID が食い違った
RESET MASTER を打たずに繋ぐと、こうなりました。
Last_IO_Error: The replica is connecting using CHANGE REPLICATION SOURCE TO SOURCE_AUTO_POSITION = 1, but the source has purged binary logs containing GTIDs that the replica requiresreplica が起動時に作った内部ユーザーの分の GTID を、自分で持っていたからです。primary はその番号を知りません。
GTID を使う複製では、replica を「まっさらな状態」にしてから繋ぎます。 RESET MASTER がそれをやります。
RESET MASTER は、その台のバイナリログと GTID を全消しします。 primary で打ってはいけません。 打つのは、これから replica にする台だけです。
3. Node から繋げず、ER_NOT_SUPPORTED_AUTH_MODE が出た
Error: ER_NOT_SUPPORTED_AUTH_MODE: Client does not support authentication protocol requested by serverMySQL 8.0 の既定の認証方式(caching_sha2_password)に、使っていた古いクライアントが対応していませんでした。
CREATE USER ... IDENTIFIED WITH mysql_native_password BY ... で作り直して直しました。
本番では、これは後退です。 ライブラリを新しくして caching_sha2_password のまま使うのが正しい直し方です。練習だから古い方式に落とした、と自覚して使います。
4. docker compose exec の出力が崩れた
-T を付けずに docker compose exec primary mysql ... を打つと、出力に制御文字が混ざり、grep が効きませんでした。
-T を付けると直ります。 スクリプトの中で使うときは、必ず付けます。
5. 再帰CTEが1001行で止まった
ERROR 3636 (HY000): Recursive query aborted after 1001 iterations. Try increasing @@cte_max_recursion_depthMySQL の既定の再帰上限は 1000 です。 SET SESSION cte_max_recursion_depth = 1000000; を同じセッションで先に打ちます。
-e を2回に分けると、別セッションになって効きません。 1回の -e の中に、SET と INSERT を両方書きます。
6. auto_increment_offset を変えたのに、変わらなかった
SET GLOBAL は、その後に開かれた接続にしか効きません。 既に開いている接続はそのままです。
docker compose exec を打ち直したら反映されました。 本番なら、設定ファイルに書いて再起動するのが確実です。
7. Seconds_Behind_Source が 0 なのに、データが古かった
Seconds_Behind_Source は「SQLスレッドが、いま適用しているイベントの記録時刻からの遅れ」です。
ネットワークが切れて、そもそもログが届いていないときは、適用するものが無いので 0 と表示されることがあります。 遅れていないのではなく、止まっているのに 0 に見えるわけです。
必ず Replica_IO_Running と Replica_SQL_Running を一緒に見ます。 片方でも Yes でなければ、Seconds_Behind_Source の数字に意味はありません。
8. docker compose down を忘れて、VMが固まった
①〜④で MySQL を3台、⑦で2台立てます。 ⑥で消し忘れたまま⑦に進んだところ、5台で 2.1GB を使い、VMがスワップに入って何も反応しなくなりました。
⑥の冒頭で docker compose down -v を打つ手順を入れたのは、これが理由です。
後片づけ
MySQL はメモリを大きく使います。必ず消してください。
1. シャードのほうを消す
[+] Running 3/3
 ✔ Container sl-shard0   Removed
 ✔ Container sl-shard1   Removed
 ✔ Network shard_default Removed
2. レプリケーションのほうも、消えているか確認する
⑥で消しているはずですが、念のため確認します。
何も出なければ消えています。 残っていたら:
3. コンテナが1つも残っていないことを確かめる
何も出なければ成功です。
4. ポートが空いたことを確かめる
何も出なければ正解です。
5. メモリが戻ったことを確かめる
               total        used        free      shared  buff/cache   available
Mem:           3.8Gi       598Mi       2.7Gi        1.0Mi       602Mi       3.0Gi
⓪で見た数字に戻っていれば完了です。
6. イメージを消す(任意)
他の記事でも mysql:8.0 を使っています。 また使う予定があるなら、残しておいてください。600MBほどあるので、消すと差が大きいです。
7. 作業ディレクトリを消す(任意)
rm -rf は戻せません。 パスを2回読んでから打ってください。⑥で書いた hashring.js は、あとで読み返す価値があります。消す前に中身をコピーしておくと良いです。
まとめ — 理解できたこと
- レプリケーションは、読みを分散する道具。書きは分散しない。 primary は最後まで1台で、replica は
--super-read-onlyで物理的に書けなかった。半日かけて3台にしても、書き込みが1ミリ秒も速くならなかった理由がこれ - レプリカの効き目は「速くなる」ではなく「詰まらなくなる」。 3台に振ったら primary の CPU は 291% → 99% に落ちたが、総時間は 24.2秒 → 23.0秒でほとんど変わらなかった。同じVMの中でCPUを共有していたから。分散が効くのは、装置が本当に別なときだけ
- レプリカを読むと、古い値がエラーも出さずに返る。
SOURCE_DELAY=10で確かめた。10秒間、「そんな行はありません」という正しい形の嘘を返し続けた - primary が落ちても、replica は自分から昇格しない。 「読めるが書けない」状態のまま、60秒ごとに再接続を試み続ける。放置すれば永遠にそのまま
- 昇格の第一手順は「古い primary を確実に殺す」。 これを飛ばして古い台を戻したら、同じ主キーの行が2台で別の中身になった。機械にはどちらが正しいか決められない
- 複数 primary は、書きを分散する道具ではない。 同時更新の勝者を決めるのはデータベースではなく自分。衝突を根本から避けようとすると、それはもうシャーディング
- 範囲で分けると、全体の分布は均等でも、直近10万件の100%が最後の1台に行く。 ホットスポットは「分布が均等か」では見つからない。新しいデータがどこに行くかを見る
- 剰余ハッシュは、3台→4台で 75.0% が引っ越す。 実際に数えた。1TBなら750GBが動く。「1台足す」という言葉から想像する作業量ではない
- 一貫性ハッシュなら 25.4% で済み、その全部が新しい台の担当分だった。 既存3台の間では1件も動いていない。ただし仮想ノードが1個だと、1台が78%を持つほど偏る
- シャーディングすると、JOIN・トランザクション・一意なID・集計が全部壊れる。 台をまたぐ送金で5000円が実際に消えた。両方の MySQL は「成功した」と思っている
AUTO_INCREMENTは台ごとに1から始まる。id=1の注文が2つできた。オフセットをずらす手は2台専用で、3台目で破綻する- JOIN が使えないなら、値を重複して持たせる(デノーマライズ)。 ただし整合性の責任がアプリに移る。「注文時点の名前」のように、時点を固定すべき値なら、それは妥協ではなく正しい設計
- シャーディングは最後の手段。 索引 → クエリ修正 → キャッシュ → スケールアップ → レプリカ → 機能分割 → シャーディング の順。飛ばされがちなのはスケールアップで、その限界は思っているよりずっと高い
- そして、個人サイトの規模では、この記事の構成は1つも要らない。 要らないと分かるために、一度組んだ
参考リンク
- roadmap.sh — System Design
- roadmap.sh — Backend Developer
- MySQL 8.0 リファレンス — Replication
- MySQL 8.0 リファレンス — Replication with Global Transaction Identifiers
- MySQL 8.0 リファレンス — SHOW REPLICA STATUS
- MySQL 8.0 リファレンス — Delayed Replication
- MySQL 8.0 リファレンス — Group Replication
- Azure Architecture Center — Sharding pattern
- Vitess — MySQL のシャーディングを実装したもの
- Twitter Snowflake — 分散環境でのID採番
次に読む
この記事は 【深掘り】システム設計 の 12 / 17 本目です。
上から順に読めば積み上がるように並べています。 飛ばしても構いませんが、詰まったら前の回に戻ってください。
全体の順路は はじめに にあります。
roadmap.sh のどこをやっているか
- レプリケーションは読みしか分散しない
- 範囲・ハッシュ・一貫性ハッシュの移動率
この記事は、上の項目を実際に手を動かして確かめる回です。
コメント