障害対応の回で、わざと壊して、直しました。あれで手に入れたのは 「壊れたあと、どう辿るか」 です。
前回: 読んでも消えないキュー — Kafkaとオフセット 作業場所はVMの中(Ubuntu Server)です。
~/server(Express + MySQL + Redis)、nginx の振り分け、Prometheusで監視を始める|メトリクスの収集方式とログとの違いと分散トレーシングの導入|どの処理が遅いかを特定するが動いている状態から始めます。
この記事は、その続きです。 扱うのは、壊れたあとではなく 壊れている最中 の話です。
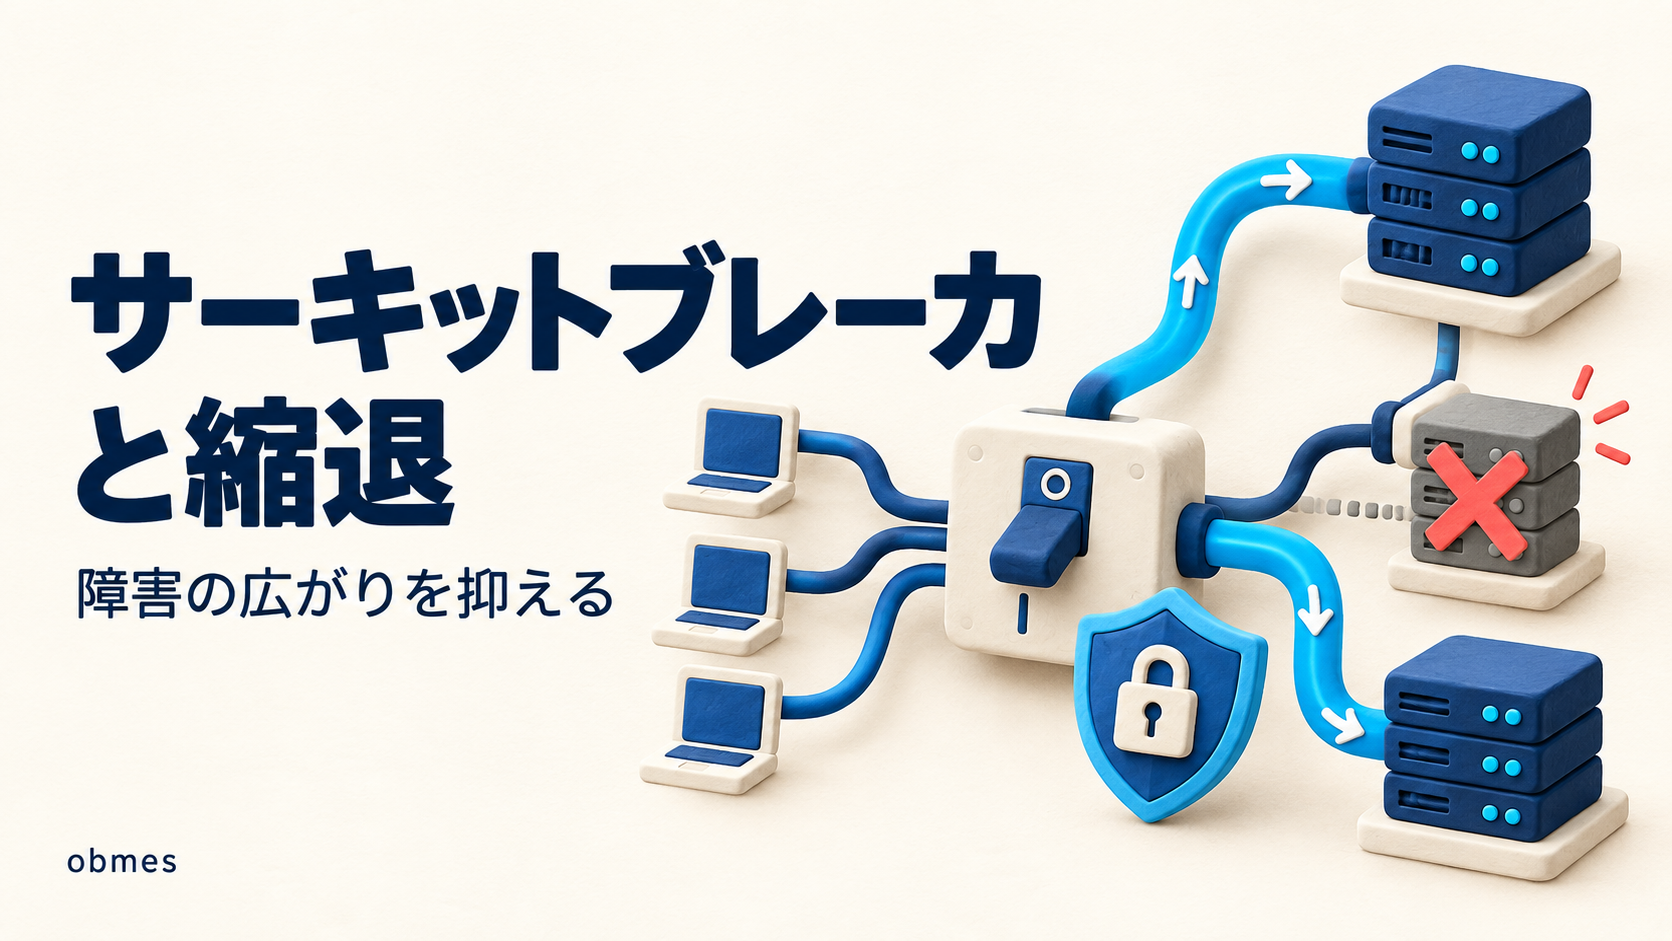
一部が壊れたときに、全部を道連れにしないこと。
なぜこれを今やるかというと、マイクロサービスの回で、こう書いたからです。
分けた瞬間、関数呼び出しが「失敗しうる通信」になる。
そして、私たちはもう 分けています。 マイクロサービスにしていなくても、~/server はすでに MySQL・Redis・nginx という別プロセスに、ネットワーク越しで頼っています。頼っている先は、落ちます。
そこで、いきなり手を動かします。 Redis を止めてください。それだけです。
そしてブラウザでアプリを開くと、ページが真っ白になります。
Redisの回で、私たちは cacheGet() を try で包んで、「Redis が落ちてもキャッシュミスと同じ扱いにする」ところまでやったはずです。それなのに真っ白です。
この記事は、その理由を突き止めるところから始まります。
対象レベル: 中級 / 区分: 必修
この記事でわかること
- 「キャッシュは落ちても大丈夫に書いた」つもりでも、セッションの置き場所が同じ Redis なら全部止まること
- タイムアウトを書いていない外部呼び出しが1本あるだけで、無関係なAPIまで死ぬこと。それがカスケード障害だということ
- 落ちている相手には、失敗を「早く返す」ほうがマシだということ。待つのは親切ではなく攻撃だということ
- 素直なリトライは、弱った相手にとどめを刺すこと(リトライストーム)。ジッターが要る理由
- サーキットブレーカは3つの状態を持つ変数にすぎず、ライブラリ無しで30行で書けること
- 縮退とは「全部か無か」をやめること。遅くても返す・一部を消して返すという選択肢があること
- これは複数のサービスがあるときの道具であること。1台のうちはタイムアウトだけで十分だということ
この記事でやること
- Redis を止めて、ページが真っ白になるのを再現し、原因を切り分ける
- わざと返事をしない相手を1つ立て、DBの接続が10本とも埋まって全滅するところまで再現する(この記事の山場)
- タイムアウトを入れて、同じ攻撃で落ちなくなることを確かめる
- リトライを、指数バックオフとジッター付きで入れる
- サーキットブレーカを自分で書く(閉 / 開 / 半開)。開いたことをログに出す
- 縮退とバルクヘッドを入れ、止めたものを全部戻して後片づけする
先に知る言葉
この記事で初めて出てくる言葉です。 基本的な言葉は用語集にもまとめてあります。
| 言葉 | 意味 |
|---|---|
| カスケード障害 | 1か所の故障が、次々と隣に燃え移って全体が止まること。ドミノ倒し |
| タイムアウト | 「ここまで待って返事が無ければ諦める」時間。待ち続けないための上限 |
| コネクションプール | DBへの接続を数本だけ作って使い回す仕組み。本数には上限がある(既定10本) |
| リトライ | 失敗したときにもう一度やり直すこと |
| リトライストーム | みんなが一斉にやり直して、弱った相手に前より多い量が届くこと。事故が大きくなる |
| 指数バックオフ | やり直す間隔を、1秒・2秒・4秒と倍にしていくこと |
| ジッター | 待ち時間にわざと乱数のばらつきを混ぜること。全員の再挑戦がそろわないようにする |
| サーキットブレーカ | 相手が壊れていると判断したら、しばらく呼ぶのをやめて即座に失敗を返す仕組み。家の分電盤のブレーカと同じ |
| 縮退運転(グレースフルデグラデーション) | 一部の機能を諦めて、残りを動かし続けること。全滅させない |
| バルクヘッド | 船の隔壁。同時実行数を区切って、1つの故障が資源を全部食い潰さないようにする |
| 冪等(べきとう) | 何回やっても結果が同じこと。GET は冪等、POST の決済は冪等ではない |
| フェイルファスト | ダメなときは、待たずにすぐ失敗を返すという考え方 |
① なぜ Redis を止めただけで真っ白になったのか
さっき止めたままのはずです。 まず現象を、思い込みではなく数字で見ます。
500 が返ります。 そして ~/server のログを見ます。
切り分ける
障害対応の回の型どおり、上から順に潰します。
| 見るもの | 結果 |
|---|---|
| nginx は生きているか | 生きている(502 ではなく 500 が返っている=後ろまでは届いている) |
| アプリは生きているか | systemctl is-active myserver@3000 は active |
| MySQL は生きているか | 生きている |
| Redis | 止めた。ここが原因 |
ここまでは想定どおりです。問題は「なぜ 500 になるのか」です。
キャッシュは、落ちても平気なように書いてあります。
const cacheGet = async (key) => {
  try {
    return await redis.get(key);
  } catch {
    return null;        // 繋がらなければ「ミス」と同じ扱いにする
  }
};
この書き方は正しいままです。 犯人は別のところにいました。
セッションの保存先です。
負荷分散の回で、アプリを2つに増やしたらログインが切れました。それを直すために、セッションを Redis に移しました。 つまり ~/server の中には、Redis に頼っている場所が2つあります。
| 頼っている場所 | 落ちたら | 書き方 |
|---|---|---|
キャッシュ(cacheGet) | キャッシュミス扱い。DBから返る | ⭕ 包んである |
| セッションストア | requireLogin が通らない → 全ルートが 500 | ❌ 包んでいない |
「落ちても大丈夫に書いた」のは、2つのうち1つだけでした。 そして落ちなかったほう(キャッシュ)は目立つほうで、落ちたほう(セッション)は自分で書いた覚えがほとんど無いほうでした。
これが、この記事全体を貫く話です。
障害に強いかどうかは、「一番弱い依存が、一番目立たないところにある」かどうかで決まります。
[スクリーンショット: 01_redis_down_500.png] sudo systemctl stop redis-server のあとに curl -i http://127.0.0.1:3000/api/stats を実行して、500 が返っている画面を撮ってください。
いったん戻す
先に進む前に、必ず戻してください。
PONG が返れば復旧です。
redis-cli -aにパスワードを直接打たないでください。 ターミナルの履歴に残ります。上の書き方は.envから取り出して渡しているので、画面にも履歴にも残りません。
② 返事をしない相手が1つあるだけで、全部が死ぬ
ここがこの記事で一番大事な節です。
さっきの Redis は「すぐエラーになる」故障でした。それは、実はマシなほうの故障です。
本当に怖いのは、落ちる故障ではありません。 「生きているけれど、返事をしない」故障です。
わざと返事をしない相手を立てる
「おすすめ記事を返してくれる別サービス」という設定にします。VMの中で作ります。
const http = require("http");

// 接続は受け付けるが、返事をしない。落ちてはいない
http.createServer((req, res) => {
  console.log(new Date().toISOString(), "接続を受けました:", req.url);
  // res.end() を呼ばない。相手はずっと待つ
}).listen(3999, "127.0.0.1", () => console.log("slow.js が 3999 で待っています"));別のターミナル(VMの中)で起動しておきます。
これは「壊れたサーバー」の一番いやらしい再現です。 ポートは開いているので接続は成功します。 だから TCP の層では何の異常も出ません。
アプリから、タイムアウト無しで呼ぶ
~/server/app.js に、次のルートを足します。 これは やってはいけない書き方の見本 です。
// ⚠️ 悪い例。このあと直します
app.get("/api/recommend", requireLogin, async (req, res) => {
  try {
    const rows = await knex.transaction(async (trx) => {
      const [me] = await trx("users").where({ id: req.session.userId });
      const r = await fetch(`http://127.0.0.1:3999/recommend?user=${me.id}`);
      const items = await r.json();
      return items;
    });
    res.json(rows);
  } catch (err) {
    console.error("[recommend]", err.message);
    res.status(500).json({ error: "おすすめを取得できませんでした" });
  }
});
この20行に、事故の種が3つ入っています。 いまは気づかなくて構いません。このあと自分の目で見ます。
再起動します。
まず1本だけ叩く
ログイン済みのクッキーが要ります。 認証の回で作ったログインを使って、クッキーをファイルに取ります。
そのクッキーで、1本だけ呼びます。
20秒たっても返りません。 curl 側の --max-time で打ち切られます。
curlを諦めさせても、アプリの中の処理は生きたまま待ち続けています。 ここが肝心です。 クライアントが帰っても、サーバーは待つのをやめません。
ここからが本題 — 関係ないAPIを巻き添えにする
別のターミナルで、同じ /api/recommend を同時に12本投げます。
投げたら、5秒ほど待ってから、まったく関係ないAPIを叩いてください。
1分ほど待たされたあと、/api/stats が 500 を返します(knex は既定で、接続の空きを60秒待ってから諦めます)。おすすめ機能とは、コードの上で1文字も関係がないのにです。ログを見ます。
[recommend] Knex: Timeout acquiring a connection. The pool is probably full.
Error: Knex: Timeout acquiring a connection. The pool is probably full.
Are you missing a .transacting(trx) call?
これがカスケード障害です。
何が起きたのか
絵で言うと、こうです。
| 段 | 起きたこと |
|---|---|
| 1 | slow.js が返事をしない |
| 2 | /api/recommend が、DBの接続を1本つかんだまま待ち続ける(knex.transaction の中で fetch している) |
| 3 | 同じことが12本。knex のプールは既定で最大10本 |
| 4 | 10本が全部埋まる |
| 5 | /api/stats が接続を借りようとして、借りられずに死ぬ |
| 6 | アプリ全体が 500 を返す。ページは真っ白 |
落ちたのは「おすすめ」だけのはずでした。実際に落ちたのは、サービス全部です。
さっき「事故の種が3つある」と書いたのは、これです。
| 種 | なぜまずいか |
|---|---|
fetch にタイムアウトが無い | 待つ上限が無い。相手が返事をしなければ永遠に待つ |
外部呼び出しを transaction の中でやっている | 待っている間ずっとDBの接続を握っている。一番希少な資源を、一番遅い処理が占有する |
| 同時実行数に上限が無い | 1つの機能が、プールを全部食い潰せてしまう |
この3つを、これから順に潰します。 1つ目がタイムアウト、2つ目が縮退の考え方、3つ目がバルクヘッドです。
[スクリーンショット: 02_pool_exhausted.png] journalctl に Knex: Timeout acquiring a connection. The pool is probably full. が出ている画面を撮ってください。
片づけます。 走っている curl を止めて、アプリを再起動します。
③ タイムアウトを入れる(一番効く1行)
この記事でやることの中で、費用対効果が飛び抜けて高いのがこれです。
タイムアウトは「遅い相手を切る設定」ではありません。 「自分の資源が、いつ返ってくるかを保証する設定」です。
Node.js には、そのための書き方が用意されています。
const r = await fetch(url, { signal: AbortSignal.timeout(800) });AbortSignal.timeout(800) は 800ミリ秒たったら、その fetch を中断してくれる合図です。中断されると TimeoutError が投げられます。
さっきのルートを、こう直します。
app.get("/api/recommend", requireLogin, async (req, res) => {
  try {
    // ① DBの用事は先に終わらせて、接続を返す
    const [me] = await knex("users").where({ id: req.session.userId });

    // ② 外部呼び出しは、DBの接続を持っていない状態でやる
    const r = await fetch(`http://127.0.0.1:3999/recommend?user=${me.id}`, {
      signal: AbortSignal.timeout(800),
    });
    if (!r.ok) throw new Error(`recommend が ${r.status} を返しました`);

    res.json(await r.json());
  } catch (err) {
    console.warn("[recommend]", err.name, err.message);
    res.status(503).json({ error: "おすすめは一時的に利用できません" });
  }
});
変えたのは3つです。
transactionをやめた。 DBの用事を先に済ませ、接続を返してから外を呼びますAbortSignal.timeout(800)を付けた- 500 ではなく 503 を返すようにした。 503 は「一時的に無理」という意味で、自分のバグではなく相手の不調だと後で読み分けられます
再起動して、さっきと同じ攻撃をかけます。
今度は /api/stats が 200 を、いつもの速さで返します。 /api/recommend は 0.8 秒で 503 を返して終わります。
おすすめ機能は壊れたままです。それでいいのです。 壊れたものが1つで済んだ、というのが今回の成果です。
どれくらいの値にするか
「とりあえず3秒」と書きたくなります。 それだと根拠が無いので、詰まったときに動かせません。決め方は3つあります。
(1)実測の p95 から決める
トレーシングの回で、どこに何ミリ秒かかっているかを見られるようになりました。あるいは監視の回のヒストグラムでも構いません。
タイムアウト ≒ ふだんの p95 の 3〜4倍
p95 が 200ms なら 600〜800ms です。平均ではなく p95 を使うのは、平均は遅い側の裾を隠すからです。
(2)上から予算を配る(タイムアウト予算)
呼ぶ側のタイムアウトは、呼ばれる側より必ず長くなければいけません。 逆だと、下が頑張って返した頃には上が諦めています。
| 層 | 値 | 理由 |
|---|---|---|
| ブラウザ(利用者の我慢) | 約3秒 | ここが全体の上限 |
| nginx → アプリ | 2秒 | ブラウザより短く |
| アプリ → おすすめサービス | 800ms | さらに短く |
| アプリ → Redis | 300ms | キャッシュは速いのが取り柄。遅いなら使わないほうが速い |
上から下へ、必ず短くしていきます。 これをタイムアウト予算と呼びます。
(3)人間の感覚を下限にする
利用者が待てるのは3秒程度です。どれだけ丁寧に計算しても、その中に収まらないなら、そもそも設計が間違っています。
忘れがちな2か所にも入れる
fetch だけ直して満足しないでください。 待つ場所は他にもあります。
Redis クライアント(app.js の接続部分):
const redis = createClient({
  url: process.env.REDIS_URL,
  socket: {
    connectTimeout: 300,
    reconnectStrategy: (retries) => Math.min(retries * 200, 3000),
  },
});
knex のプール(プールが空のとき、いつまで待つか):
const knex = require("knex")({
  client: "mysql2",
  connection: { /* いままでどおり */ },
  pool: { min: 2, max: 10, acquireTimeoutMillis: 3000 },
});nginx(後ろのアプリが返事をしないときの上限):
proxy_connect_timeout 2s;
proxy_send_timeout    5s;
proxy_read_timeout    5s;
nginx -tが OK を出すまでreloadしないでください。 リバースプロキシの回と同じ手順です。
④ リトライ — 素直に書くと事故が大きくなる
タイムアウトを入れると、次にこう思います。
「失敗したなら、もう一度やればいいのでは?」
半分正しく、半分は危険です。
まず、危険なほうから
素直なリトライは、こうなります。
// ⚠️ これは書いてはいけません
for (let i = 0; i < 3; i++) {
  try { return await fetch(url); } catch {}
}
何が起きるか、数字で見ます。 相手が重くて、毎秒100件の要求をさばけずに落ちかけているとします。
| 相手に届く量 | |
|---|---|
| リトライ無し | 100 /秒 |
| 3回リトライ | 300 /秒 |
弱っている相手に、いつもの3倍を送りつけています。
これがリトライストームです。相手が回復しかけた瞬間に、全員のリトライが同時に着弾して、また落ちます。 そして落ちたのでまたリトライする。永久に立ち上がれません。
しかも、全員が同じタイミングで失敗しているので、リトライも同じタイミングでそろいます。
指数バックオフとジッター
直し方は2つ同時に入れます。
| 対策 | やること |
|---|---|
| 指数バックオフ | 待つ時間を倍にしていく(200ms → 400ms → 800ms)。回復する時間を相手に与える |
| ジッター | 待ち時間に乱数を混ぜる。全員の再挑戦がそろわないようにする |
const sleep = (ms) => new Promise((r) => setTimeout(r, ms));

async function retry(fn, { attempts = 3, baseMs = 200 } = {}) {
  let lastErr;
  for (let i = 0; i < attempts; i++) {
    try {
      return await fn();
    } catch (err) {
      lastErr = err;
      if (i === attempts - 1) break;
      const backoff = baseMs * 2 ** i;          // 200 → 400 → 800
      const wait = Math.random() * backoff;     // ⚠️ ここがジッター
      console.warn(`[retry] ${i + 1}回目失敗。${Math.round(wait)}ms 待ちます: ${err.message}`);
      await sleep(wait);
    }
  }
  throw lastErr;
}
Math.random() * backoff の1行がジッターです。「0からbackoffまでの間でばらけさせる」やり方で、AWS の文書では full jitter と呼ばれています。待ち時間の平均は半分になるのに、衝突は激減します。
ジッターを入れないバックオフは、ほとんど意味がありません。 全員が「1秒後」に同じことをするなら、それは1秒後に同じ事故が起きるだけだからです。
リトライしてはいけないもの
ここを間違えると、リトライは「不具合」ではなく「事故」になります。
| 相手の返事 | リトライ | 理由 |
|---|---|---|
| 接続できない / タイムアウト | ⭕ する | 相手に届いていない可能性がある |
| 503 / 429 | ⭕ する(Retry-After があれば従う) | 相手が「いまは無理」と言っている |
| 500 | △ 原則しない | 相手のバグ。何度やっても同じ |
| 400 / 401 / 404 | ❌ 絶対にしない | こちらが悪い。 100回やっても直らない |
そして、返事の種類より大事な基準が1つあります。
冪等でない操作は、リトライしてはいけません。
「タイムアウトした」は「届かなかった」ではありません。 届いて、処理されて、返事だけが返ってこなかったかもしれません。
| 操作 | リトライすると |
|---|---|
GET /api/tasks | 何回やっても同じ。安全 |
POST /api/payments(決済) | 2回引き落とされる可能性がある |
POST /api/tasks(作成) | 同じタスクが2つできる |
どうしてもリトライしたいなら、相手が「同じ依頼だ」と気づけるようにします。
await fetch(url, {
  method: "POST",
  headers: { "Idempotency-Key": requestId },  // 依頼ごとに1つ、変わらないID
  body: JSON.stringify(body),
});
受け側は、このIDをすでに処理済みなら、処理せずに前回の結果を返します。 トランザクションの回で作った一意制約が、ここで効きます。
「返事が要らない仕事」なら、そもそもリトライを自分で書かないほうが楽です。 メッセージキューの回でやったとおり、キューを挟めば、再送はキューの仕事になります。
使ってみる
さっきの /api/recommend に組み込みます。
const items = await retry(() =>
  fetch(url, { signal: AbortSignal.timeout(800) }).then((r) => {
    if (!r.ok) throw new Error(`recommend が ${r.status}`);
    return r.json();
  })
, { attempts: 2 });
attempts は 2 にしました。 3にしたくなりますが、タイムアウト 800ms × 3回 + 待ち時間で、利用者は2秒以上待たされます。リトライは、タイムアウト予算の中に収まる回数しかできません。
⑤ サーキットブレーカを、30行で書く
リトライまで入れて、まだ足りません。
slow.js はまだ返事をしません。 つまり、呼ぶたびに必ず 800ms を捨てています。 1分間に100回呼べば、80秒ぶんを、返ってこないと分かっている相手に払っているわけです。
相手が壊れているなら、呼ばないのが一番速い。
これがサーキットブレーカです。家の分電盤のブレーカと、考え方はまったく同じです。落ちているあいだ、電気は来ませんが、家は燃えません。
3つの状態しかない
| 状態 | 何をするか | いつ移るか |
|---|---|---|
| 閉(closed) | ふつうに呼ぶ。 失敗を数える | 失敗が閾値を超えたら → 開 |
| 開(open) | 呼ばない。即座に失敗を返す(フェイルファスト) | 一定時間たったら → 半開 |
| 半開(half-open) | 試しに1本だけ通す | 成功なら → 閉 / 失敗なら → 開 |
「閉じている=通電している=正常」です。日本語の直感と逆なので、ここだけ気をつけてください。
書く
ライブラリは使いません。 ~/server/breaker.js を作ります。
function createBreaker({ name = "breaker", failureThreshold = 5, openMs = 10000 } = {}) {
  let state = "closed";
  let failures = 0;
  let openedAt = 0;
  let trialInFlight = false;      // 半開のとき、通すのは1本だけ

  return async function call(fn) {
    if (state === "open") {
      if (Date.now() - openedAt < openMs) {
        throw new Error(`[${name}] 回路が開いています`);   // ← 呼ばずに即失敗
      }
      state = "half-open";
      trialInFlight = false;
      console.warn(`[breaker] ${name} → 半開(試しに1本だけ通します)`);
    }
    if (state === "half-open" && trialInFlight) {
      throw new Error(`[${name}] 半開の試行中です`);
    }
    if (state === "half-open") trialInFlight = true;

    try {
      const result = await fn();
      if (state !== "closed") console.warn(`[breaker] ${name} → 閉(復旧しました)`);
      state = "closed";
      failures = 0;
      trialInFlight = false;
      return result;
    } catch (err) {
      trialInFlight = false;
      failures++;
      if (state === "half-open" || failures >= failureThreshold) {
        state = "open";
        openedAt = Date.now();
        console.error(`[breaker] ${name} → 開(連続失敗 ${failures} 回。${openMs}ms 呼びません)`);
      }
      throw err;
    }
  };
}

module.exports = { createBreaker };
30行ちょっとです。 中身は 状態を持つ変数3つと、if が4つしかありません。
サーキットブレーカに難しい理論はありません。 「連続で失敗したら、しばらく呼ぶのをやめる」を、そのままコードにしただけです。 名前が仰々しいので身構えますが、自分で書けます。
なぜ「失敗を早く返す」ほうがマシなのか
ここを納得しないと、この道具は使えません。 3つ理由があります。
| 理由 | 中身 |
|---|---|
| 自分を守る | 待っている間、こちらの資源(接続・メモリ・スレッド)は塞がっている。 ②で見たとおり |
| 相手を守る | 落ちかけている相手への流量が、ゼロになる。 回復する時間を与えられる |
| 利用者に早く伝えられる | 30秒待たせて「エラー」より、0.1秒で「いまおすすめは出せません」のほうがずっとマシ |
待つのは親切ではありません。 相手が回復しようとしている最中に、要求を投げ続けるのは、攻撃と同じです。
組み込む
app.js の上のほうに1つ作ります。
const { createBreaker } = require("./breaker");
const recommendBreaker = createBreaker({ name: "recommend", failureThreshold: 5, openMs: 10000 });ルートは、retry の外側を包みます。
app.get("/api/recommend", requireLogin, async (req, res) => {
  try {
    const [me] = await knex("users").where({ id: req.session.userId });
    const items = await recommendBreaker(() =>
      retry(() =>
        fetch(`http://127.0.0.1:3999/recommend?user=${me.id}`, {
          signal: AbortSignal.timeout(800),
        }).then((r) => {
          if (!r.ok) throw new Error(`recommend が ${r.status}`);
          return r.json();
        })
      , { attempts: 2 })
    );
    res.json(items);
  } catch (err) {
    console.warn("[recommend]", err.message);
    res.status(503).json({ error: "おすすめは一時的に利用できません" });
  }
});
入れ子の順番に意味があります。
ブレーカが外、リトライが内。 逆にすると、「開いている」という即失敗を、リトライが3回やり直すことになります。無意味な上に、ログが3倍出ます。
開くところを見る
503 1.712s
503 1.655s
503 1.783s
503 1.629s
503 1.748s
503 0.004s
503 0.003s
503 0.004s
6本目から、時間が 1.7 秒前後 → 0.004 秒に落ちています。 ここでブレーカが開きました。ログを見ます。
[breaker] recommend → 開(連続失敗 5 回。10000ms 呼びません)10秒待ってからもう1本叩くと、半開になります。
[breaker] recommend → 半開(試しに1本だけ通します)
[breaker] recommend → 開(連続失敗 6 回。10000ms 呼びません)
相手はまだ壊れているので、すぐ開に戻ります。正しい動きです。
[スクリーンショット: 03_breaker_open_log.png] journalctl に [breaker] recommend → 開 と → 半開 が並んでいる画面を撮ってください。
直したら閉じることを確かめる
slow.js を、ちゃんと返事をする版に差し替えます。
const http = require("http");
http.createServer((req, res) => {
  res.setHeader("Content-Type", "application/json");
  res.end(JSON.stringify([{ id: 1, title: "おすすめ記事A" }]));
}).listen(3999, "127.0.0.1", () => console.log("slow.js(正常版)が 3999 で待っています"));
Ctrl+C で止めて、起動し直します。10秒待ってから叩きます。
[breaker] recommend → 半開(試しに1本だけ通します)
[breaker] recommend → 閉(復旧しました)
200 が返り、ブレーカが自動的に閉じました。 誰も再起動していません。
これが半開の価値です。 開きっぱなしなら、人間が直すまで機能は死んだままです。 半開があるから、相手が直った瞬間に、勝手に戻ります。
⑥ 縮退 — 全部か無かにしない
ここまでは「呼ばない」話でした。 呼ばないと決めたあと、利用者に何を返すかが縮退です。
縮退とは、「全部動くか、全部死ぬか」という二択をやめることです。
(1)Redis が落ちたら、遅くてもDBから返す
①で見たとおり、cacheGet はすでに縮退しています。
const cached = await cacheGet(key);   // Redis が落ちていれば null
if (cached) return res.json(JSON.parse(cached));
// ↓ ミス扱いで、そのままDBを引く
Redis が落ちても、/api/stats は動きます。遅くなるだけです。
「速いが壊れやすい道」と「遅いが確実な道」を両方持って、前者がダメなら後者に落ちる。 これが縮退の一番きれいな形です。
ただし、これには前提が要ります。 DBが、キャッシュ無しの負荷に耐えられることです。パフォーマンスの回でやったとおり、キャッシュが無いと10秒かかるような処理なら、Redis が落ちた瞬間にDBが道連れになります。そのときは「遅くても返す」ではなく「その機能だけ諦める」に切り替えます。
(2)セッションは、縮退できない
①で真っ白の原因だったセッションはどうするか。
結論から書くと、ここは正直に諦めます。
「Redis が落ちたらログイン不要にする」は、絶対にやってはいけません。 認証を落とす縮退は、縮退ではなく穴です。
やるのは、これだけです。
| やること | 意味 |
|---|---|
| ログインが要らない画面は、Redis が落ちても表示できるようにする | トップページや記事一覧を requireLogin の外に出す |
| 500 ではなく「ログインが一時的にできません」を返す | 真っ白より、原因が分かるほうがまし |
app.js のセッション設定の下に、これを足します。
// セッションストア(Redis)が落ちたときに、真っ白にしない
app.use((err, req, res, next) => {
  if (err && /session|redis/i.test(err.message)) {
    console.error("[session]", err.message);
    return res.status(503).json({ error: "ログイン機能が一時的に利用できません" });
  }
  next(err);
});
(3)おすすめ欄だけ消して、ページは出す
一番よく使う縮退はこれです。 画面側が 「1つでも失敗したら全部表示しない」書き方になっていると、全滅します。
// ⚠️ 悪い例。1つコケたら catch に飛んで、全部出ない
const [stats, tasks, recommend] = await Promise.all([
  fetch("/api/stats").then((r) => r.json()),
  fetch("/api/tasks").then((r) => r.json()),
  fetch("/api/recommend").then((r) => r.json()),
]);
Promise.all は「1つでも失敗したら、全部失敗」です。 非同期処理の回でやった性質が、そのまま障害に直結します。
Promise.allSettled に変えるだけで、縮退になります。
const results = await Promise.allSettled([
  fetch("/api/stats").then((r) => r.json()),
  fetch("/api/tasks").then((r) => r.json()),
  fetch("/api/recommend").then((r) => r.json()),
]);

const [stats, tasks, recommend] = results.map((r) =>
  r.status === "fulfilled" ? r.value : null
);

render({ stats, tasks });
if (recommend) {
  renderRecommend(recommend);     // 出せるときだけ出す
} else {
  hideRecommendPanel();           // ⚠️ エラーを出すのではなく、欄ごと消す
}「おすすめを取得できませんでした」と赤字を出すより、欄ごと消すほうがいい場面が多いです。 利用者は、そもそもその欄があったことを知りません。
代替値には落とし穴がある
「失敗したら、代わりに何か返せばいい」は、行き過ぎると危険です。
| やっていい縮退 | やってはいけない縮退 |
|---|---|
| おすすめ欄を消す | 在庫数を、取れなかったので「あり」と返す |
| キャッシュが無いのでDBから引く | 残高が取れなかったので 0 円と返す |
少し古いデータを返す(stale-while-revalidate) | 権限が取れなかったので「許可」にする |
「安全側に倒す」の安全側が、どっちなのかを毎回考えてください。 迷ったら、嘘の値を返すより、正直に 503 を返すほうがましです。
そしてもう1つ。代替の道も、ふだんから動かしてください。 障害のときにしか通らないコードは、障害のときに動きません。 これは AWS の技術文書でも繰り返し警告されている話です。
⑦ バルクヘッド — 同時実行数を区切る
②で見つけた「事故の種」の3つ目が、まだ残っています。 1つの機能が、プールを全部食い潰せてしまう問題です。
船には、隔壁(バルクヘッド)が入っています。 船底に穴が空いても、区画1つが浸水するだけで、船は沈みません。 ソフトウェアでも同じことをします。
「おすすめ」が使っていい同時実行数を、あらかじめ区切っておく。 区切っておけば、その機能が全部おかしくなっても、被害はその区画の中で止まります。
一番小さい実装は、数を数えるだけです。
function createBulkhead(limit) {
  let running = 0;
  return async function run(fn) {
    if (running >= limit) throw new Error(`同時実行の上限 ${limit} に達しています`);
    running++;
    try {
      return await fn();
    } finally {
      running--;      // ⚠️ finally で必ず戻す。ここを忘れると、いつか全部埋まる
    }
  };
}

const recommendBulkhead = createBulkhead(4);   // プール10本のうち、最大4本まで
使うときは、ブレーカのさらに外側です。
const items = await recommendBulkhead(() => recommendBreaker(() => retry(/* ... */)));これで、/api/recommend に何本殺到しても、同時に走るのは4本までです。残りは即座に失敗します。②の実験をもう一度やっても、DBのプールは6本残ります。
バルクヘッドは、ブレーカが開くまでの「あいだ」を守る道具です。 ブレーカは連続5回失敗するまで開きません。 その5回のあいだに、全部食い潰されては意味がないからです。
⑧ 落ちたことに、自分が気づく
ここまでの仕組みには、共通した副作用があります。
うまく作るほど、壊れていることに気づかなくなります。
おすすめ欄が消えていても、ページは出ます。 利用者は文句を言いません。そして半年後、その機能は死んだままだったと分かります。
(1)ログに、状態の変化だけを出す
breaker.js は、すでに console.error / console.warn を書いてあります。 大事なのは書き方です。
| 出すもの | 出さないもの |
|---|---|
| 状態が変わった瞬間だけ(閉→開、開→半開、半開→閉) | 開いているあいだの失敗を毎回 |
開いているあいだは、1秒に何百回も失敗します。 それを全部ログに出すと、Loki が障害中に一番いらないログで埋まります。 障害中にログが読めなくなるのは、よくある二次災害です。
(2)数えられる形にする
Prometheus に出すなら、カウンタを1つ増やすだけです。
// prom-client を使っている前提(監視の回で入れたもの)
const breakerOpens = new client.Counter({
  name: "app_breaker_open_total",
  help: "サーキットブレーカが開いた回数",
  labelNames: ["name"],
});
// breaker.js の「開」に移るところで
breakerOpens.inc({ name });
アラートの条件は、これで十分です。
app_breaker_open_totalが 5分間で 1 以上増えたら通知する。
(3)トレースに印を付ける
トレーシングの回で入れた自動計装は、呼んでいない処理をスパンにできません。 ブレーカが開いていると、外部呼び出しのスパンが、ある時刻から忽然と消えます。
「スパンが無い」は、目で追うのが難しい異常です。 だから印を付けます。
const { trace } = require("@opentelemetry/api");
trace.getActiveSpan()?.setAttribute("breaker.state", "open");
これで、トレース画面から「このリクエストは、開いていたので呼んでいない」と読めます。
⑨ やりすぎない — これはどこから必要になるのか
ここまで5つの仕組みを入れました。正直に線を引きます。
サーキットブレーカとバルクヘッドは、複数のサービスがあるときの道具です。 アプリが1台で、依存が MySQL と Redis だけなら、タイムアウトだけで十分です。
理由は3つあります。
| 理由 | 中身 |
|---|---|
| 効果が出る条件が「呼び先が複数ある」こと | 1つしか依存が無いなら、それが落ちたら結局サービスは止まる。 開いても救うものが無い |
| 状態を持つコードは、バグる | ブレーカはプロセスごとに別の状態を持ちます。2台なら2つの独立したブレーカがあり、片方だけ開きます |
| 開きっぱなしのブレーカは、自作の障害 | 閾値を間違えると、相手は元気なのに呼ばなくなります。 私はこれを実際にやりました(後述) |
この記事の中での優先順位
もし1つしか入れないなら、迷わずこれです。
| 順 | 入れるもの | 効果 |
|---|---|---|
| 1 | タイムアウト | ⭐⭐⭐ これだけで②のカスケード障害は起きません |
| 2 | 外部呼び出しを、DBの接続を持ったままやらない | ⭐⭐⭐ コストゼロ。書き方の問題だけ |
| 3 | Promise.allSettled にする(画面の縮退) | ⭐⭐ 1行 |
| 4 | ジッター付きリトライ | ⭐ 呼び先が2つ以上になってから |
| 5 | バルクヘッド | ⭐ 同上 |
| 6 | サーキットブレーカ | ⭐ 呼び先が3つ以上になってから |
1と2は、いま全員がやるべきです。 3も1行です。4以降は、マイクロサービスの回で書いたとおり「困ってから」で間に合います。
そして、ここまで自分で書いたあとなら、ライブラリを使う判断もできます。 Node.js には opossum という定番があります。中でやっていることは、⑤で書いた30行とほぼ同じです。先に自分で書いたので、設定項目の意味が全部わかります。
Kubernetes やサービスメッシュを入れると、この一部は基盤側でやってくれます。 ただし、基盤がやってくれるのはタイムアウトとリトライまでです。「おすすめ欄を消してページは出す」は、アプリにしか判断できません。
つまずいたところ
1. タイムアウトを入れたのに、/api/stats がまだ死んだ
③で AbortSignal.timeout(800) を入れた直後、まだプールが枯れました。
原因は、knex.transaction を消し忘れていたことでした。タイムアウトを入れたので800msで返るようにはなったのですが、その800msのあいだ、DBの接続を握ったままでした。12本同時なら、0.8秒間だけ、プールは全滅します。
タイムアウトは「握る時間を短くする」だけで、「握らない」にはしてくれません。 一番効くのは、
transactionの外にfetchを出したことでした。
この順で確かめると分かります。
2. 半開のとき、10本まとめて通してしまった
最初に書いたブレーカには trialInFlight がありませんでした。
open から half-open に移ったあと、同時に来た10本が全部「半開だから通す」判定になり、壊れている相手に10本まとめて投げました。 これでは開いていた意味がありません。
[breaker] recommend → 半開(試しに1本だけ通します)
[breaker] recommend → 半開(試しに1本だけ通します)
[breaker] recommend → 半開(試しに1本だけ通します)「半開」という言葉を、「少し通す」だと読んでいたのが間違いでした。正しくは「1本だけ通して、様子を見る」です。trialInFlight のフラグ1つで直りました。
「回復したかを確かめる」ための試行なのに、確かめる前に全部投げていました。
3. 閾値を 2 にしたら、相手が元気なのにブレーカが開いた
「早く開いたほうが安全だろう」と思って failureThreshold: 2 にしました。
結果、ふだんの運用でブレーカが開くようになりました。 相手は落ちていません。たまたまネットワークが2回続けて詰まっただけです。そのたびに、おすすめ欄が10秒消えました。
ブレーカを敏感にしすぎると、自分で障害を作ります。
5回にしたら止まりました。 決め方は「相手が本当に落ちているなら5回連続で失敗するし、たまたまなら5回は続かない」です。ここは実測で決めるしかありません。
4. slow.js を止め忘れて、ポートが埋まっていた
正常版に差し替えるとき、Ctrl+C を押したつもりで押していませんでした。 新しい slow.js は EADDRINUSE で起動に失敗していたのに、別の窓だったので気づきませんでした。
トレーシングの回でも、同じ失敗をしています。 「設定したのに効かない」と思ったら、まず自分の変更が本当に動いているかを疑う。3回目です。
後片づけ
slow.jsは、必ず止めてください。 3999番を掴んだままになります。
slow.js を動かしているターミナルで Ctrl+C。 残っていないか確認します。
何も出なければOKです。 出るなら、番号を確認してから止めます。
ディレクトリごと消して構いません。
/api/recommend は、呼び先が無くなるので必ず 503 を返します。 残しておいても害はありませんが、消すならルートごと消してください。 ブレーカとバルクヘッドの定義も一緒に消します。
クッキーのファイルも消します。
cookie.txtにはログイン済みのセッションIDが入っています。 セキュリティ点検の回で書いたとおり、そのまま置いておくと、それだけでログインできてしまいます。
正常に動くことを確認する
止めたものが全部戻っているか、上から順に確かめます。
5つとも active になっていることを確認してください。
そして、障害対応の回で覚えた「再起動まで含めて確認する」をやります。
上がってきたら、もう一度 systemctl is-active を打ってください。 active に戻っていなければ、enable されていないだけです(systemd の回)。
[スクリーンショット: 04_degraded_page.png] 再起動後に systemctl is-active を打って、5つとも active が並んでいる画面を撮ってください。
~/server、appdb、~/monitoringは残してください。 続きの回で使います。 nginx に足したproxy_*_timeoutと、knex のacquireTimeoutMillisは、残してください。 入れっぱなしで得しかありません。
まとめ
- 依存は落ちる。 MySQL も Redis も nginx も、すでにネットワーク越しの別プロセスである
- 「キャッシュは落ちても大丈夫に書いた」は、半分だった。 セッションストアが同じ Redis だった
- 一番弱い依存は、一番目立たないところにある。 自分で書いた覚えのない場所を疑う
- 落ちる故障より、「生きているのに返事をしない」故障のほうがずっと怖い
- タイムアウトが無い呼び出しが1本あると、DBのプール10本が埋まって全滅する(カスケード障害)
- 外部呼び出しを
transactionの中でやらない。 一番希少な資源を、一番遅い処理に握らせない - タイムアウトは「遅い相手を切る設定」ではなく「自分の資源がいつ返るかの保証」
- 値は p95 の3〜4倍。 上から下へ、必ず短くしていく(タイムアウト予算)
- 素直な3回リトライは、弱った相手に3倍を送りつける(リトライストーム)
- 指数バックオフは、ジッターとセットでなければほぼ意味がない(
Math.random() * backoff) - 400番台はリトライしない。 冪等でない
POSTもリトライしない(Idempotency-Keyを付けるなら別) - サーキットブレーカは、状態変数3つと
if4つ。 30行で書ける。ライブラリは後でいい - 閉=正常。 日本語の直感と逆なので注意
- 失敗を早く返すのは、①自分を守り ②相手に回復の時間を与え ③利用者を待たせないため
- ブレーカが外、リトライが内。 逆にすると即失敗を3回やり直す
- 半開は「少し通す」ではなく「1本だけ通す」。 ここを間違えると開いた意味が消える
- 閾値を敏感にしすぎると、自分で障害を作る(2回はダメだった。5回で止まった)
- 縮退は「全部か無か」をやめること。 遅くても返す / 一部を消して返す
Promise.allをPromise.allSettledにするだけで、画面は全滅しなくなる- 認証を落とす縮退はしない。 在庫や残高に嘘の代替値を返さない。 迷ったら 503
- 障害のときにしか通らないコードは、障害のときに動かない。 代替の道も常に通しておく
- バルクヘッドは、ブレーカが開くまでの「あいだ」を守る。
finallyで必ずカウンタを戻す - うまく作るほど、壊れていることに気づかなくなる。 状態が変わった瞬間だけをログに出す
- これは呼び先が複数あるときの道具。 1台のうちは、タイムアウトと「transaction の外で呼ぶ」だけで十分
参考リンク
- roadmap.sh — System Design
- roadmap.sh — Backend
- Martin Fowler — CircuitBreaker
- Microsoft — Circuit Breaker pattern
- Microsoft — Retry pattern
- Microsoft — Bulkhead pattern
- AWS Builders’ Library — Timeouts, retries, and backoff with jitter
- AWS Builders’ Library — Avoiding fallback in distributed systems
- Google SRE Book — Handling Overload
- Google SRE Book — Addressing Cascading Failures
- Node.js —
AbortSignal.timeout - MDN —
Promise.allSettled - Knex.js — プールの設定
- node-redis — 再接続とタイムアウトの設定
- nginx —
proxy_read_timeout - opossum — Node.js のサーキットブレーカ実装
次に読む
この記事は 【第8段階】深掘り の 11 / 30 本目です。
| 記事 | |
|---|---|
| ← 前の記事 | 読んでも消えないキュー — Kafkaとオフセット |
| → 次の記事 | LLMは検索ではない — 埋め込みとRAGを手で書く |
上から順に読めば積み上がるように並べています。 飛ばしても構いませんが、詰まったら前の回に戻ってください。
全体の順路は はじめに にあります。
コメント