Grafana– tag –
-

Kubernetesの監視と調べ方 — logsが空なのに落ちている
Pod が動かないので kubectl logs を打ったのに、何も出ませんでした。原因はアプリではなく、そもそも「まだ起動していない」ことでした。この記事では、Pending / ImagePullBackOff / CrashLoopBackOff / Running なのに繋がらない / Running なのに遅い の5つの症状から「最初に打つコマンド」を決める表を作り、events・logs の各オプション・exec・debug・port-forward・status.conditions・describe node を実際に全部打ちます。そのうえで Helm で監視を1つだけ入れ、Grafana で最初に見るべき画面(ノードの資源と Pod の再起動回数)を決め、Kubernetes 固有の指標とアラートの設計、k9s などの道具まで進みます。 -
Prometheusは取りに行く — 監視とログの入口
動いているかを人が見に行くのをやめる回。メトリクスとログは別物という整理から入り、Prometheusが「取りに来る」設計を押さえて、Grafanaまで立てます。Grafanaを -p で公開するとufwを素通りして外から見える話と、Prometheusがディスクを食う話つき。 -
ログが3箇所に散っている — Lokiで1画面にする
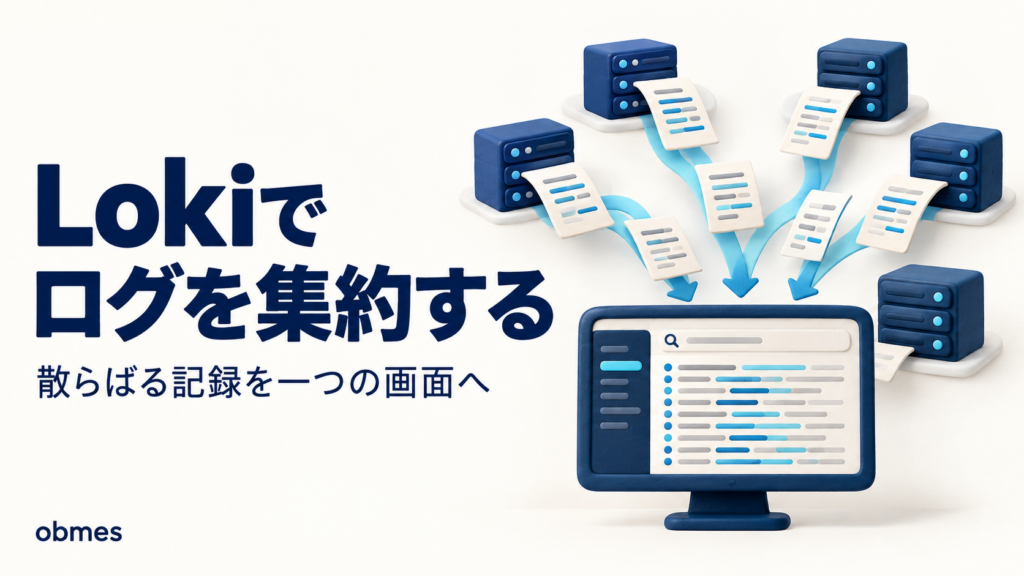
障害のたびに journalctl と nginx のログと docker logs を行き来していた話。前回わざと先送りにしたログ集約を、Loki と Promtail で回収します。なぜ Elasticsearch ではなく Loki なのか、ラベルで絞るとはどういうことか、そして秘密情報をログに出すと保存先が新しい漏洩経路になる話つき。保持期間の設定を忘れるとディスクが減り続けます。 -
監視は自前かSaaSか — 替えられるのは道具だけ
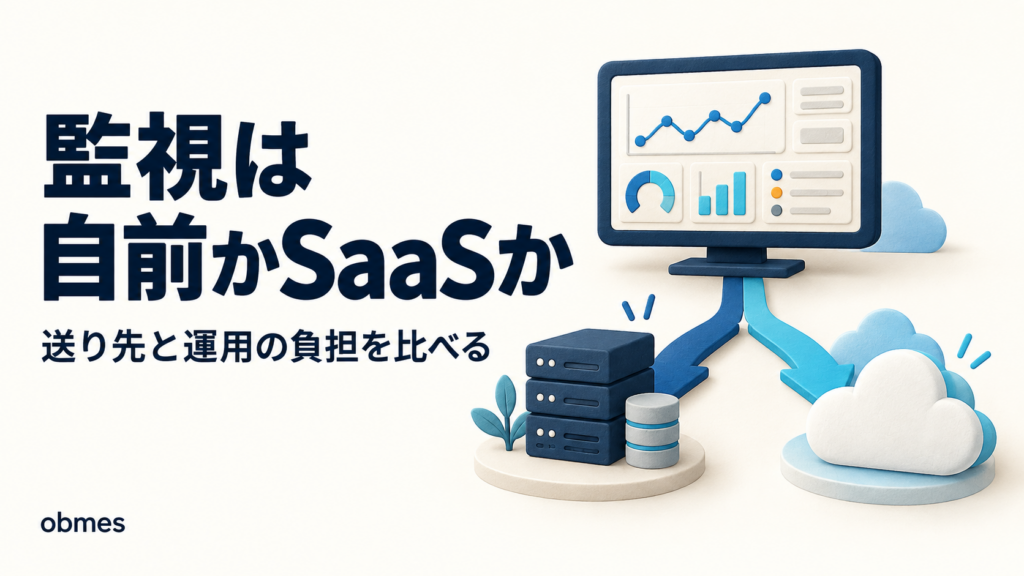
Prometheus・Grafana・Loki・OpenTelemetry を自前で立てたあとに残った穴から始めます。監視サーバーが落ちたとき、誰が気づくのか。そして山場は「道具を替えても、アプリのコードは変わらない」を実際に確かめること。OpenTelemetry Collector を1つ挟んで、アプリを1文字も触らずに送り先を差し替えます。そのうえで自前とSaaSの判断軸を表にし、Datadog・Zabbix・Elastic などの位置づけを1行ずつ、監視が「送った量」で課金されること、鳴りすぎるアラートが無意味であることまで書きます。料金は書きません。

1