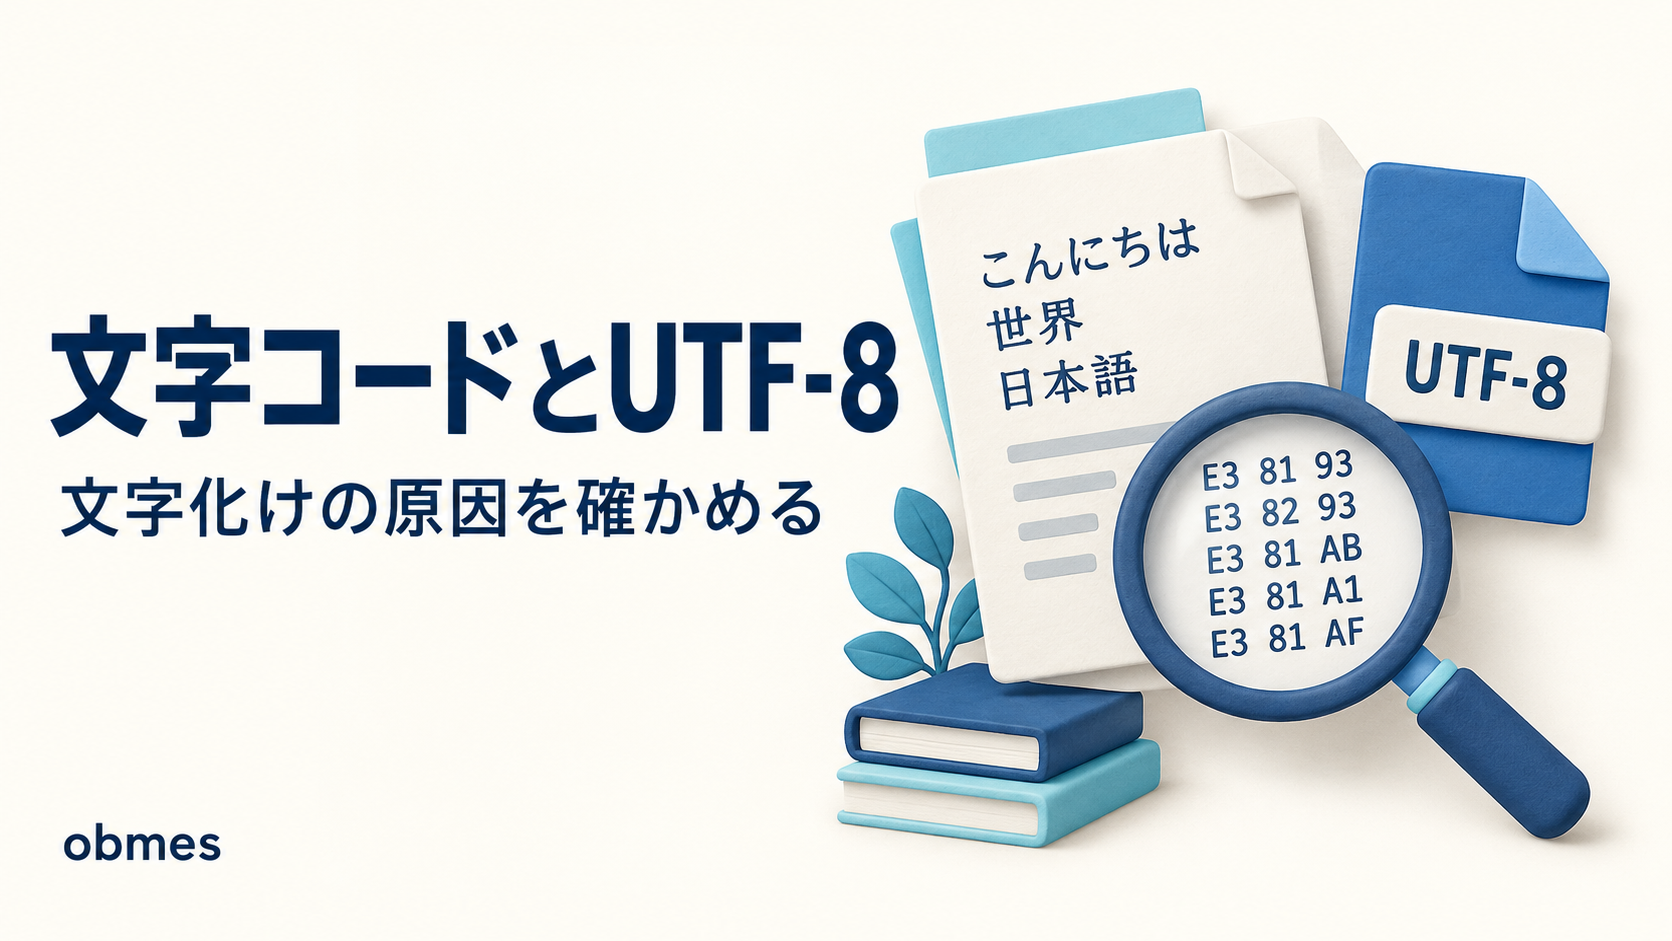
文字化けの最中に何が起きているのかを、バイト列を見ながら確かめます。文字集合と符号化方式の関係を押さえます。
前回: 2進数と浮動小数点 — 0.1+0.2が0.3にならない
これは【深掘り】の記事です。本線の順路ではありません。 読まなくても先へ進めます。 本線の 文字化けは壊れたのではない — 文字コードとUTF-8 の続きとして、「では、化けている最中に何が起きているのか」を、実際に自分の手で化けさせて、バイト列を目で見ながら直します。 本線では「UTF-8 にしておけば大丈夫」で終わらせました。この記事は、その「大丈夫」が破れる場所を全部見に行きます。
この記事のコマンドは、VMの中(Ubuntu Server)で打ちます。 Windows の PowerShell では打ちません。 Windows 側で打つ箇所は1つだけあり、そこには明示的に「PowerShell で」と書きます。
前提: Linuxの基本コマンド と grep・sed・awkとvim を一度触っていること。 Node.js を使います。入っていない場合は APIの正体はJSONを返すHTTP — Node.jsで作る の導入部分だけ先にやってください。
似たタイトルの記事があります。役割が違います。 この記事は仕組みを、バイト列を見て確かめるを扱います。文字化けは壊れたのではない — 文字コードとUTF-8 はいま化けているものを直す手順を扱います。
対象レベル: 中級〜上級 / 区分: 発展
私がやったこと
VM の中で、こういう CSV を作りました。
名前,部署
山田,営業
佐藤,開発
これを Windows にコピーして、Excel で開きました。
蜷榊燕,驛ィ鄂イ
螻ア逕ー,蝟カ讌ュ
菴占陸,髢狗匱
私はこのとき「ファイルが壊れた」と判断しました。 コピーの途中で化けたのだと思い、もう一度コピーし直し、また同じ結果になり、3回目で VM に戻って全部打ち直しました。
打ち直したものも、同じように化けました。
ここで初めて「コピーの問題ではない」と気づきました。そして、私が一番の誤解をしていたのはここです。
❌ 「文字化けは、ファイルが壊れた状態である」
⭕ 文字化けは、ファイルが壊れていない状態である。 バイト列は1バイトも変わっていない。変わったのは、それを文字に戻すときの読み方だけ。
壊れていたら直せません。 でも読み方が違うだけなら、正しい読み方を教えるだけで直ります。 そして「教える」ためには、どう読んでいるのかを自分で分かっていないといけない。
それが分からないと、何が困るか。
- 化けた画面を見て「壊れた」と判断して、直せるものを作り直してしまう(私がやりました)
- 文字化けを直そうとして、化けたものを保存し直して、二度と戻せなくする(後述します。これが一番怖い)
lengthが期待と違う理由が分からず、文字数制限のバグを一生踏み続ける- 絵文字を入れた瞬間 DB が
Incorrect string valueで落ちる理由が分からない - JSON が「1文字目が変」と言って落ちるのに、エディタで開いても何も見えない
この記事で最初に受け取ってほしいのは、これ1つです。
コンピュータは文字を持っていません。持っているのは数字だけです。
段階 中身 誰が決めるか 文字 あ人間 番号(コードポイント) U+3042Unicode という規格 バイト列 E3 81 82符号化方式(UTF-8 / UTF-16 / CP932 …) ファイルに入っているのは一番下の行だけです。 上の2行はファイルの中に書かれていません。 だから読む側が方式を推測するしかなく、推測を間違えると化けます。
この記事でわかること
- 文字は最初から数字だったこと。
Aが65、aが97で、差の32はビット1個の差であること。そして ASCII には128文字しかなく、日本語は最初から入っていない - 文字化けはファイルの破損ではないこと。バイト列は変わっておらず、解釈だけが変わっている。だから
xxdで見れば化ける前と後で中身が同じだと確認でき、正しい方式を指定すれば元に戻る fileやnkf --guessの文字コード判定は「推測」でしかないこと。統計で当てているだけで、短いファイルほど外す- コードポイント(
U+3042)と、それをバイトにする方式(UTF-8 / UTF-16 / UTF-32)は別のものであること。ここを混ぜると一生わからない - プログラムは文字数を正しく数えられないこと。絵文字で
lengthが8になる理由(サロゲートペア・書記素クラスタ)と、がが2通りのバイト列で書けること(NFC / NFD) - BOM という「見えない3バイト」が、JSON のパースとシェルスクリプトを壊すこと。エディタで開いても見えないので、
xxdでしか見つけられない - 文字コードは4箇所で宣言すること(HTML の
<meta charset>・HTTP のContent-Type・DBの照合順序・プログラムの読み込み時)。1箇所でも違うと、そこで化ける - 迷ったら UTF-8(BOM無し)・改行 LF で、例外は「Excel に渡す CSV」だけであること
この記事でやること
- ASCII の表を自分で出力し、
A= 65 とa= 97 の差がビット1個であることを2進数で確かめる - 日本語のファイルをわざと化けさせ、
xxdでバイト列そのものを見て、正しい方式を指定して元に戻す fileとnkf --guessに判定させ、わざと外させる- Node.js で
Bufferの長さを測り、UTF-8 が1〜4バイトの可変長で ASCII 互換であることを見る - 絵文字と結合文字で
lengthを壊し、Intl.Segmenterで正しく数え直す - BOM 付きのファイルを作って JSON とシェルスクリプトを壊し、
sedで取り除く - HTML・HTTP・MySQL・Node.js のどこで文字コードを指定するのかを、実際に動かして突き合わせる
- 作ったものを全部消す
先に知る言葉
この記事で初めて出てくる言葉です。 基本的な言葉は用語集にもまとめてあります。
| 言葉 | 意味 |
|---|---|
| 文字集合(キャラクタセット) | どの文字に何番を割り当てるかの一覧。ASCII、Unicode などがこれ。バイトの話はまだしていない |
| 符号化方式(エンコーディング) | 番号を実際のバイト列にする決まり。UTF-8 / UTF-16 / CP932 などがこれ |
| コードポイント | Unicode が文字に振った番号。U+3042(あ)のように U+ と16進数で書く |
| ASCII | 1963年からある7ビット・128文字の文字集合。英数字と記号だけ。日本語は入っていない |
| UTF-8 | Unicode の番号を 1〜4バイトの可変長でバイトにする方式。ASCII の範囲は1バイトでそのまま。いま作るものはこれ |
| CP932(Shift_JIS系) | Windows が長く日本語に使ってきた方式。Microsoft が独自に拡張したもので、素の Shift_JIS とは別物 |
| BOM | Byte Order Mark。ファイル先頭に付く「これは UTF-8 です」という印。UTF-8 では不要なのに付くことがあり、事故になる |
| サロゲートペア | UTF-16 で16ビットに収まらない文字を、2個の値の組で表す仕組み。JavaScript の length がずれる原因 |
| 書記素クラスタ | 人間が「1文字」と思う単位。👨👩👧 は人間には1文字だが、内部では複数のコードポイント |
| 正規化(NFC / NFD) | 同じ見た目を1つの形に揃える処理。が を1文字で持つ(NFC)か、か + 濁点で持つ(NFD)かの違い |
iconv | 文字コードを変換するコマンド。Ubuntu に最初から入っている |
xxd | ファイルを16進数のバイト列として表示するコマンド。画面に出る文字を信じないための道具 |
① 文字は最初から数字だった
まず作業場所を作ります。 この記事で作るものは、全部この中に入れます。
/home/ユーザー名/cslab/encpwd の結果が cslab/enc で終わっていることを確認してください。 以降のコマンドはすべてこの中で打ちます。
ASCII の表を自分で出す
Ubuntu には ascii の man ページが入っている場合があります。まず見てみます。
「No manual entry for ascii」と出た場合は入っていません。入れます。
が、man を読むより自分で出したほうが腑に落ちます。 Node.js で表を作ります。
v20.19.0バージョンが出ればOKです。 「command not found」なら Node.jsで作る の導入だけ先に済ませてください。
ascii.js を作ります。
 32:    33:!   34:"   35:#   36:$   37:%   38:&   39:'
 40:(   41:)   42:*   43:+   44:,   45:-   46:.   47:/
 48:0   49:1   50:2   51:3   52:4   53:5   54:6   55:7
 56:8   57:9   58::   59:;   60:<   61:=   62:>   63:?
 64:@   65:A   66:B   67:C   68:D   69:E   70:F   71:G
 72:H   73:I   74:J   75:K   76:L   77:M   78:N   79:O
 80:P   81:Q   82:R   83:S   84:T   85:U   86:V   87:W
 88:X   89:Y   90:Z   91:[   92:\   93:]   94:^   95:_
 96:`   97:a   98:b   99:c  100:d  101:e  102:f  103:g
104:h  105:i  106:j  107:k  108:l  109:m  110:n  111:o
112:p  113:q  114:r  115:s  116:t  117:u  118:v  119:w
120:x  121:y  122:z  123:{  124:|  125:}  126:~
📷 スクリーンショット: この ASCII 表が出た画面を撮っておいてください。この記事で以降ずっと参照します。「文字は数字」を目で見た最初の証拠です。
ここで見ておいてほしいのは、数字の並び方です。
0は 48 から始まり、1,2… と連続しているAは 65 から始まり、B,C… と連続しているaは 97 から始まる
0 が 48 なので、'7' - '0' を計算すると 7 になります。 文字を数値に変換する処理は、昔からこの引き算でした。
65 と 97 の差が「ビット1個」であること
A = 65 = 01000001
a = 97 = 01100001
差 = 32
2進数で並べると、違っているのは左から3番目のビット1個だけです。
つまり大文字と小文字の変換は、ビットを1個ひっくり返すだけでできます。
a
Aこれは偶然ではなく、そうなるように番号を決めたからです。1960年代の計算機で toLowerCase を安く実装するための設計でした。
ASCII には128文字しかない
ここが、この記事の全部の話の出発点です。
ASCII の文字数: 128
7ビットで表せる数: 128
うち印字できるもの: 95
ASCII は7ビット・128文字。 そのうち印字できるのは95文字で、英数字と記号だけです。 日本語は1文字も入っていません。 ひらがな・カタカナ・漢字は、後から各国が勝手に拡張しました。 その「勝手に拡張した」やり方が国ごと・会社ごとに違ったことが、文字化けのすべての原因です。
1バイトは8ビットあるので、ASCII は128〜255の領域を空けています。 ここに何を入れるかを各国が別々に決め、日本だけでも複数の方式(Shift_JIS / EUC-JP / ISO-2022-JP)ができました。同じバイト列が、方式によって別の文字になります。
それを実際に見ます。
② わざと化けさせて、バイト列を見る
日本語のファイルを UTF-8 で作る
名前,部署
山田,営業
普通に読めます。 ここで画面に出た文字を信じずに、バイト列を見ます。
00000000: e590 8de5 898d 2ce9 83a8 e7bd b20a e5b1  ......,.........
00000010: b1e7 94b0 2ce5 96b6 e6a5 ad0a            ....,.......
左が16進数のバイト列、右がそれを ASCII として読もうとした結果です。 右側が . ばかりなのは、ASCII の範囲外だから表示できないという意味です。
1文字ずつ切ってみると分かりやすくなります。
00000000: e590 8d                                  ...
00000000: 41                                       A
名は3バイト(e5 90 8d)、Aは1バイト(41)。41は10進数で 65 です。①で見たA= 65 と、同じ数字です。 UTF-8 は、ASCII の範囲をそのままのバイト値で持ちます。 これが「ASCII 互換」の意味です。
CP932 に変換する(=別の読み方でバイトを作り直す)
-rw-rw-r-- 1 user user 20 Sep 30 10:12 cp932.txt
-rw-rw-r-- 1 user user 28 Sep 30 10:11 utf8.txt
同じ内容なのに、サイズが 28 と 20 で違います。
00000000: 96bc 914f 2c95 948f 900a 8e52 9363 2c89  ...O,......R.c,.
00000010: 638b c60a                                c...
日本語1文字が2バイトになっています。 名 は UTF-8 では e5 90 8d の3バイトでしたが、CP932 では 96 bc の2バイトです。だから20バイトに縮んでいます。
化ける瞬間を見る
���O,���������ST����c��(表示は端末によって変わります。読めない記号や ? の列が出れば成功です。)
ここで起きたことを正確に言い直します。
catは「ファイルを表示するコマンド」ではありません。catはバイト列をそのまま端末に投げるだけです。 文字にしているのは端末(ターミナル)です。 そして私の端末は UTF-8 で読むように設定されています。 CP932 のバイト列を UTF-8 として読んだ結果が、この記号の列です。
端末の設定を確認します。
LANG=en_US.UTF-8UTF-8 と書いてあります。 端末は「入ってくるバイトは UTF-8 だ」と思って読んでいます。ファイルは CP932 なので、当然合いません。
直す = 読み方を教える
名前,部署
山田,営業
戻りました。 ここで大事なのは、戻すために cp932.txt を一切書き換えていないことです。
2b1c4a...  cp932.txt
2b1c4a...  cp932.txt
ハッシュが同じ=ファイルは1バイトも変わっていません。
文字化けはファイルの破損ではありません。 ファイルの中身は最初から最後まで同じで、変わったのは「どの方式で読むか」だけです。 だから作り直す必要は一度もありませんでした。 私は3回作り直しました。
逆向きに間違えて、有名な化け方を出す
UTF-8 のファイルを CP932 だと思って読ませます。 これが Windows でよく見る化け方です。
iconv: 位置 12 に不正な入力シーケンスがありますエラーで止まりました。 これはむしろ良い知らせです。
「文字コードのエラーが出た」は、実は幸運なケースです。 エラーで止まってくれれば、間違いに気づけます。 本当に怖いのは、エラーにならずに、それっぽい別の文字になって通ってしまうケースです。
強引に続けさせると、何が起きるか見ておきます。 -c は「変換できないバイトを捨てて続ける」オプションです。
蜷榊燕,驛ィ鄂イ
螻ア逕ー,蝟カ讌ュ
これが、私が最初に見た画面です。 冒頭の 蜷榊燕 と同じ形が出ました。
蜷や縺から始まる文字列を見たら、UTF-8 を CP932 として読んでいます。 これは覚えておくと本当に役に立つサインです。UTF-8 の日本語はe3 81 xxe5 xx xxのような並びで始まり、それを CP932 の2バイト文字として切ると、縺や蜷の系統に落ちるからです。
そして、ここが一番危ない場所です。
00000000: e89c b7e6 a68a e787 952c e9a9 9bef bda8  .........,......
00000010: e984 82ef bdb2 0ae8 9ebb efbd b1e9 8095  ................
これは「取り返しがつかなくなった」状態です。 さっきまでは読み方を変えれば戻る状態でした。でも今回は、化けた結果を保存してしまいました。
-cで捨てられたバイトは、もう戻りません。文字化けを見たとき、絶対にやってはいけないのは「化けた状態で保存し直すこと」です。 直す前に必ず元ファイルのコピーを取る。これだけで救われます。
③ 文字コードの見分け方(ただし推測でしかない)
「このファイルは何コードなのか」を調べる道具はあります。 ただし、その全部が推測です。
file に聞く
utf8.txt:  Unicode text, UTF-8 text
cp932.txt: Non-ISO extended-ASCII text
UTF-8 は当てられました。 でも CP932 のほうは「ISO じゃない拡張 ASCII」と、方式を言い当てていません。
nkf に聞く
nkf は日本語の文字コード判定に強い道具です。入っていなければ入れます。
Command 'nkf' not foundNetwork Kanji Filter Version 2.1.5 (2018-12-15)UTF-8 (LF)
Shift_JIS (LF)両方当てました。 しかも改行コードまで教えてくれます((LF) の部分)。これは便利です。
わざと外させる
判定は統計です。 「このバイトの並びは、この方式なら自然」という当てはめをしているだけです。短いファイルには材料がありません。
tiny.txt: ASCII text, with no line terminators
ASCII (LF)
A だけのファイルは「ASCII」と判定されます。 でもこのファイルは、
- UTF-8 のファイルとしても正しい
- CP932 のファイルとしても正しい
- ISO-8859-1 のファイルとしても正しい
全部正解です。 バイト 41 は、どの方式でも A なので、区別できません。
もっと悪い例を作ります。
amb.txt: Non-ISO extended-ASCII text, with no line terminators
Shift_JIS (LF)日2バイトのファイルは、方式を変えると別の文字になったり、エラーになったりします。 判定した側はどちらか一方を選んで言っているだけです。
fileもnkf --guessも、正解を知りません。 統計で当てているだけです。 短いファイル・記号だけのファイル・数字だけのファイルほど外します。 正解を知っているのは、そのファイルを作った人だけです。 だから「文字コードはファイルの外で宣言する」という設計になっています(⑦でやります)。
BOM があれば当てられる
例外が1つあります。 先頭に BOM が付いていれば、推測せずに断定できます。
withbom.txt: Unicode text, UTF-8 (with BOM) text(with BOM) と断定されました。 ただしこの BOM が、⑥で JSON とシェルスクリプトを壊します。
④ Unicode の構造 — 番号と、バイトにする方式は別物
ここが、この記事で一番大事なセクションです。
「Unicode」と「UTF-8」を同じものだと思っていると、一生わかりません。
何か 例 Unicode 文字に番号を振る一覧表。バイトの話をしていない あはU+3042UTF-8 その番号をバイト列にする方式 U+3042→e3 81 82(3バイト)UTF-16 同じ番号を、別のやり方でバイト列にする方式 U+3042→42 30(2バイト)UTF-32 同じ番号を、常に4バイトで持つ方式 U+3042→42 30 00 00(4バイト)
あの番号はU+3042で、どの方式でも変わりません。 変わるのはバイトへの入れ方だけです。 「Unicode で保存する」という言い方は、正確ではありません。 方式を言わないと保存できません。
同じ文字を3つの方式で出す
文字  コードポイント   UTF-8  UTF-16LE  UTF-32LE
A    U+0041         1B     2B        4B
あ   U+3042         3B     2B        4B
漢   U+6F22         3B     2B        4B
𩸽   U+29E3D        4B     4B        4B
😀   U+1F600        4B     4B        4B

A → UTF-8: 41  UTF-16LE: 4100
あ → UTF-8: e38182  UTF-16LE: 4230
漢 → UTF-8: e6bca2  UTF-16LE: 226f
𩸽 → UTF-8: f0a9b8bd  UTF-16LE: 67d83dde
😀 → UTF-8: f09f9880  UTF-16LE: 3dd800de
📷 スクリーンショット: この表が出た画面を撮ってください。この記事の残り全部が、この表の読み方の話です。
この表から読み取れることを、順番に並べます。
1. UTF-8 は可変長で、ASCII は1バイトのまま
A : 1 バイト
あ: 3 バイト
𩸽: 4 バイト
A が1バイトということは、英数字だけのファイルは UTF-8 でも ASCII のファイルと1バイトも変わりません。
完全に同じこれが UTF-8 が世界標準になった一番の理由です。 昔からある ASCII のファイルは、何もしなくてもそのまま正しい UTF-8 のファイルです。 UTF-16 はそうではありません。
Aが41 00の2バイトになるので、既存のプログラムが全部壊れます。
2. UTF-16 は「2バイト固定」ではない
𩸽 と 😀 は、UTF-16 でも4バイトになっています。これがサロゲートペアで、⑤の主題です。
3. UTF-16 にはバイトの並び順の問題がある
あ の番号は U+3042 なのに、UTF-16LE のバイト列は 4230 です。逆順になっています。
LE: 4230
BE: 3042
UTF-16 と UTF-32 は「どちらから並べるか」を決めないと読めません。 小さい桁から並べるのが LE(リトルエンディアン)、大きい桁からが BE です。 この「どっちか」を伝えるために作られたのが BOM(Byte Order Mark)です。 UTF-8 は1バイト単位なので、並び順の問題が最初からありません。だから UTF-8 に BOM は不要です。 にもかかわらず付けられることがあり、それが⑥の事故になります。
4. UTF-8 の中身には規則がある
A 01000001
あ 11100011 10000001 10000010
𩸽 11110000 10101001 10111000 10111101
先頭バイトのビットを見てください。
| 先頭バイトの形 | 意味 |
|---|---|
0xxxxxxx | 1バイト文字(=ASCII) |
110xxxxx | これから2バイト続く文字の1バイト目 |
1110xxxx | これから3バイト続く文字の1バイト目 |
11110xxx | これから4バイト続く文字の1バイト目 |
10xxxxxx | 続きのバイト(文字の先頭ではない) |
これが UTF-8 の賢いところです。 どのバイトを見ても、それが文字の先頭かどうかが分かります。 だから途中から読み始めても、文字の境界を復元できます。 ファイルの真ん中で切れても、次の文字から読み直せます。 CP932 にはこれがありません。 1バイトずれると、そこから先が全部ずれ続けます。
⑤ 文字数が数えられない
ここからが、実際に業務でバグになる部分です。
length は文字数ではない
"abc" length = 3 コードポイント数 = 3 バイト数(UTF-8) = 3
"あいう" length = 3 コードポイント数 = 3 バイト数(UTF-8) = 9
"𩸽" length = 2 コードポイント数 = 1 バイト数(UTF-8) = 4
"😀" length = 2 コードポイント数 = 1 バイト数(UTF-8) = 4
"👨👩👧" length = 8 コードポイント数 = 5 バイト数(UTF-8) = 18
"が" length = 1 コードポイント数 = 1 バイト数(UTF-8) = 3𩸽 は1文字なのに length が 2。👨👩👧 は1文字なのに length が 8。
なぜ 2 なのかを見ます。
length      : 2
s[0]        : d867
s[1]        : de3d
codePointAt : 29e3d
JavaScript の文字列は、UTF-16 の値の並びです。
lengthは「文字数」ではなく「UTF-16 の値がいくつあるか」です。U+29E3Dは 16ビット(最大U+FFFF)に収まりません。そこでD800〜DBFFとDC00〜DFFFの2個の値の組で表します。 これがサロゲートペアです。
なぜこの範囲が空いているかというと、Unicode が「サロゲート用」としてこの領域に文字を割り当てないと決めているからです。 だからこの2個の並びを見たら、必ずペアだと分かります。
slice で文字が割れる
ここが実際のバグです。
元      : 𩸽の煮付け
slice(0,3): 𩸽の
slice(0,1): "\ud867"
slice(0,1) の結果は、ペアの片方だけです。 これはどの文字でもない値で、画面には � のような箱で出ます。
「20文字までに切る」を
slice(0, 20)で書くと、20文字目が絵文字だったときに文字が割れます。 割れた片方をDBに保存すると、取り出したときも壊れています。 JSON にすると"\ud867"という単独サロゲートになり、受け取った側のパーサが落ちることがあります。
正しく数える2つの方法
方法1: スプレッド構文(コードポイント単位)
5 [ '𩸽', 'の', '煮', '付', 'け' ][...s] はコードポイント単位で分けるので、サロゲートペアを割りません。 for...of も同じです。
方法2: Intl.Segmenter(人間の1文字=書記素クラスタ単位)
でも [...s] でも足りない場合があります。 家族の絵文字です。
length : 8
[...s] : 5 [ '👨', '', '👩', '', '👧' ]中身は「男・見えない結合子・女・見えない結合子・女の子」の5個でした。 は ZWJ(ゼロ幅接合子) という幅のない文字で、「前後をくっつけて1つの絵として表示せよ」という指示です。
人間には1文字です。 それを数えるのが Intl.Segmenter です。
文字列 length [...s] Segmenter
abc 3 3 3
𩸽の煮付け 6 5 5
👨👩👧 8 5 1
😀😀 4 2 2
が 1 1 1
Intl.Segmenterのgraphemeが、人間の「1文字」に一番近い数え方です。 Node.js 16 以降で使えます。node -vが古い場合は上げてください。
3つを使い分ける基準を表にします。
| 数えたいもの | 使うもの | いつ使うか |
|---|---|---|
| UTF-16 の値の数 | s.length | 使わない。 意味のある単位ではない |
| コードポイント数 | [...s].length | 文字を割らずに切るとき。slice の代わり |
| 人間の見た目の1文字 | Intl.Segmenter | 「20文字まで」の表示制限、カーソル移動 |
| バイト数 | Buffer.byteLength(s, 'utf8') | DBの列幅、通信量、ファイルサイズ |
結合文字と正規化 — が が2通りある
もう1つ、length を狂わせるものがあります。
NFC  : が length = 1 cp = U+304C
NFD  : が length = 2 cp = U+304B U+3099
見た目は同じか  : 目で見てください
=== で等しいか  : false
バイト列(NFC)   : e3818c
バイト列(NFD)   : e3818be38299
normalize後に等しいか: true
画面には同じ
がが2つ並んでいるのに、===はfalseです。 見た目が同じでも、バイト列が違えば別の文字列です。プログラムは見た目を比べません。
これが実際に事故になる場面が、はっきりあります。
が.txt が.txt同じ名前のファイルが2つ並んでいます。 Linux のファイル名はバイト列なので、別のファイルとして共存できます。
00000000: e381 8be3 8299 2e74 7874 0ae3 818c 2e74  .......txt.....t
00000010: 7874 0a xt.バイト列で見ると、e3818b e38299(NFD)と e3818c(NFC)で違います。
が.txt
grep 'が'で1つしか出てきません。 ターミナルから入力したがは NFC なので、NFD のファイル名にはヒットしません。これは macOS が絡むと現実に起きます。 macOS のファイルシステムはファイル名を NFD に近い形に分解して保存します。 macOS で作ったファイルを Linux のサーバーに上げると、ファイル名が NFD で入ります。 すると Linux 側の
findやgrep、アプリの検索でヒットしなくなります。 「ファイルはあるのに見つからない」の正体がこれです。
対策は「入り口で正規化する」の一択です。
正規化なし: 1 件
正規化あり: 2 件
文字列を保存する前・比較する前に
normalize('NFC')を通す。 これを入り口の1箇所でやります。 NFC を選ぶ理由は、Web と DB の世界の既定が NFC だからです。HTML の仕様も NFC を推奨しています。
⑥ BOM — 見えない3バイトがファイルを壊す
④で「UTF-8 に BOM は不要」と書きました。 ここでは付いていると何が起きるかを、実際に壊して見ます。
壊れる例1: JSON のパースが落ちる
{ name: 'obmes', port: 3000 }正常です。 ここに BOM を付けます。
SyntaxError: Unexpected token in JSON at position 0落ちました。 ここで一番厄介な点を見ます。
{ "name": "obmes", "port": 3000 }
catしても、エディタで開いても、何も変わって見えません。 BOM は「幅のない文字」なので、画面に出ないのです。 「見た目は完全に正しいのに、パーサだけが落ちる」 ——これが BOM の事故の形です。
見つける唯一の方法が xxd です。
00000000: efbb bf7b 2022 6e61 6d65 223a 2022 6f62  ...{ "name": "ob
00000000: 7b20 226e 616d 6522 3a20 226f 6222 2c20  { "name": "ob",
efbbbf の3バイトが先頭に増えています。 これが BOM です。
📷 スクリーンショット: この
xxdの2行を並べた画面を撮ってください。「見えないものを見る」という作業が、この記事で一番身につけてほしい習慣です。
壊れる例2: シェルスクリプトの1行目が死ぬ
こちらのほうがエラーメッセージが不親切で、時間を取られます。
./hello.sh: 行 1: #!/bin/bash: そのようなファイルやディレクトリはありません
./hello.sh: 行 2: $'echo': コマンドが見つかりません「#!/bin/bash というファイルがありません」と言われました。
これは、カーネルが1行目を #! で始まっていないと判断したからです。 実際の1行目は <BOM>#!/bin/bash なので、#! はファイルの先頭にありません。
00000000: efbb bf23 212f 6269 6e2f 6261 7368 0a ...#!/bin/bash.efbbbf のあとに 23 21(=#!)が来ています。 順番が問題です。
「shebang を書いたのに
そのようなファイルやディレクトリはありませんと言われる」は、BOM か改行コード(CRLF)です。 どちらもxxdで1行目の先頭と末尾を見れば一瞬で分かります。
sed で BOM を取る
00000000: 2321 2f62 696e 2f62 6173 680a 6563 686f  #!/bin/bash.echo
こんにちは
動きました。 JSON のほうも同じ方法で直せます。
{ name: 'obmes', port: 3000 }tail で「先頭3バイトを捨てる」書き方もあります。
00000000: 7b20 226e 616d 6522 3a20 226f 6222 2c20 { "name": "ob",tail -c +4 は「4バイト目から出す」=3バイト捨てる、という意味です。 BOM があると確信できている場合だけ使ってください。無いファイルに使うと、本物の3文字を消します。
BOM をまとめて探す
何も出なければ、BOM 付きのファイルは残っていません。
BOM が必要になる場面は1つだけあります。⑧で扱う「Excel に渡す CSV」です。 それ以外では付けません。 エディタの保存設定で「UTF-8」と「UTF-8 with BOM」が並んでいたら、必ず前者です。
⑦ 実務では、どこに文字コードを書くのか
③で「正解を知っているのはファイルを作った人だけ」と書きました。 だからファイルの外で宣言する仕組みが、層ごとに用意されています。そのどれか1つが違うと、そこで化けます。
HTML の <meta charset>
わざと宣言を間違えたものも作ります。
page.html:<meta charset="UTF-8">
page_bad.html:<meta charset="Shift_JIS">
両方のファイルの中身(バイト列)は、charset の行以外まったく同じです。 それでも page_bad.html はブラウザで化けます。
別のターミナル(もう1つ SSH で入る)から確認します。
Content-Type: text/htmlHTTP のヘッダに
charsetが付いていません。 HTTP ヘッダのcharsetは、HTML の<meta charset>より優先されます。 つまりサーバー側の設定が間違っていると、HTML をいくら直しても化けます。 これは実際にハマる順番の逆で、HTML を10回直しても直りません。
優先される順番を表にします。
| 優先度 | どこ | 例 |
|---|---|---|
| 1(最強) | ファイル先頭の BOM | ef bb bf |
| 2 | HTTP ヘッダの Content-Type | Content-Type: text/html; charset=UTF-8 |
| 3 | HTML の <meta charset> | <meta charset="UTF-8"> |
| 4 | ブラウザの推測(③と同じ統計) | — |
<meta charset> を書くときの注意が1つあります。
<!DOCTYPE html>
<html lang="ja">
<head>
<meta charset="UTF-8">
<title>タイトル</title>
</head>
<meta charset>は<head>の中で、先頭から1024バイト以内に書きます。 ブラウザはそこまで読んで見つからなければ推測に切り替えます。 だから<title>より前に置きます。<title>に日本語が入っていると、宣言前に日本語を読ませることになります。
サーバーを止めます(python3 を動かしているターミナルで Ctrl + C)。
HTTP の Content-Type; charset
自分でヘッダを付けて、違いを見ます。 Node.jsで作る と同じ形の小さいサーバーです。
content-type: text/html; charset=UTF-8
content-type: text/html
charsetを書かないと、受け取った側が推測します。 ③でやったとおり、推測は外れます。 API を作るときは、Content-Type: application/json; charset=UTF-8を必ず付ける。 (JSON の仕様では UTF-8 が既定なので省略しても通りますが、書いてあるほうが揉めません。)
MySQL の utf8mb4 — utf8 では絵文字が入らない
ここは、名前が罠になっている有名な場所です。 MySQLとSQLの基本 を触っていれば実際に試せます。
-- ❌ 昔からよく書かれてきた形。これは utf8mb3 で、3バイトまでしか入らない
CREATE TABLE ng (
  id   INT PRIMARY KEY AUTO_INCREMENT,
  name VARCHAR(50)
) DEFAULT CHARSET = utf8;

-- ⭕ こちらが本当の UTF-8
CREATE TABLE ok (
  id   INT PRIMARY KEY AUTO_INCREMENT,
  name VARCHAR(50)
) DEFAULT CHARSET = utf8mb4 COLLATE = utf8mb4_0900_ai_ci;④で測ったとおり、😀 は UTF-8 で4バイトです。
INSERT INTO ng (name) VALUES ('うれしい😀');ERROR 1366 (HY000): Incorrect string value: '\xF0\x9F\x98\x80' for column 'name'
\xF0\x9F\x98\x80は、④で測った😀の UTF-8 バイト列そのものです。 MySQL のutf8は「3バイトまでの UTF-8」(正式名utf8mb3)で、4バイト文字が入りません。utf8mb4が本物の UTF-8 です。mb4は max bytes 4 の意味です。utf8は歴史的な名前で、MySQL 8.0 では非推奨です。新しく作るものは必ずutf8mb4。
INSERT INTO ok (name) VALUES ('うれしい😀');
SELECT name, CHAR_LENGTH(name) AS 文字数, LENGTH(name) AS バイト数 FROM ok;
+-----------------+--------+----------+
| name | 文字数 | バイト数 |
+-----------------+--------+----------+
| うれしい😀 | 5 | 16 |
+-----------------+--------+----------+CHAR_LENGTH は文字数、LENGTH はバイト数です。 ⑤で Node.js で測ったのと同じ区別が、SQL 側にもあります。
そして、テーブルを直すだけでは足りません。
SHOW VARIABLES LIKE 'character_set%';+--------------------------+---------+
| Variable_name | Value |
+--------------------------+---------+
| character_set_client | utf8mb4 |
| character_set_connection | utf8mb4 |
| character_set_results | utf8mb4 |
| character_set_server | utf8mb4 |
+--------------------------+---------+文字コードは「サーバー」「データベース」「テーブル」「列」「接続」の5箇所にあります。 テーブルを
utf8mb4にしても、接続がlatin1なら、そこで化けます。 アプリ側の接続文字列にもcharset=utf8mb4を書く必要があります。 「DBを直したのに化ける」は、ほぼ接続の設定漏れです。
Node.js — 読み込むときに方式を渡す
最後がプログラム側です。 ここは指定を忘れると型が変わるので、間違いに気づきやすい場所です。
指定なしの型: object Buffer
指定なしの中身: <Buffer e5 90 8d e5 89 8d 2c>
utf8 指定の型: string
utf8 指定の中身: "名前"
utf8 指定の中身: "名前"

CP932 を utf8 で読む: "���"
指定なしなら
Buffer(=バイト列そのまま)、指定すればstring。Bufferのままなら化けません。 化けるのは文字にした瞬間です。�は「置換文字」(U+FFFD)で、変換できなかったバイトの代わりに表示されます。 「変換できなかった」という印です。�が出たら、元の情報はもう失われています。 ②のdamaged.txtと同じで、保存すると戻せません。
Node.js の標準では CP932 を読めません。 変換は iconv に任せるのが一番確実です。
読めた: "名前"この「入り口で UTF-8 に直して、中では UTF-8 だけを扱う」が、実務での正解の形です。
⑧ 迷ったときの判断表
私が最初に欲しかったのは、この表でした。
| 場面 | 何にするか | 理由 |
|---|---|---|
| 新しく作るテキストファイル全部 | UTF-8(BOM無し)・改行 LF | 迷う理由が無い。既定 |
| HTML | UTF-8、<meta charset="UTF-8"> を <title> より前・1024バイト以内 | ブラウザが推測に落ちるのを防ぐ |
| HTTP レスポンス | Content-Type: ...; charset=UTF-8 を必ず書く | HTML の宣言より優先される(BOM があればそちらが先) |
| MySQL / MariaDB | utf8mb4(utf8 は使わない) | utf8 は3バイトまで。絵文字が入らない |
| DBへの接続 | 接続文字列にも charset=utf8mb4 | テーブルだけ直しても接続で化ける |
| シェルスクリプト | BOM 無し・LF(絶対) | BOM で shebang が死ぬ。CRLF でも死ぬ |
| JSON | BOM 無し・UTF-8 | BOM でパーサが落ちる |
| Git に入れるもの | LF。.gitattributes に * text=auto | 環境で改行が変わるのを止める |
| ファイル名 | 保存前に normalize('NFC') | macOS 経由で NFD が混ざると検索に出ない |
| Excel に渡す CSV | UTF-8 + BOM、または CP932 | ここだけが例外(次で説明) |
例外は「Excel に渡す CSV」だけ
冒頭で私が化けさせたのは CSV でした。 そして CSV には、現実的な例外があります。
Excel は、BOM の無い UTF-8 の CSV を開くと、CP932 だと思って読みます。 つまり②で見たのと逆向きの化け方をします。
確かめます。 BOM 有りと無しの CSV を作ります。
plain.csv: Unicode text, UTF-8 text
bom.csv:   Unicode text, UTF-8 (with BOM) text
この2つを Windows 側にコピーします。
ここだけ Windows の PowerShell で打ちます。 <VMのIP> と <ユーザー名> は自分のものに置き換えてください(IPは VM 側で ip a で確認できます)。
scp <ユーザー名>@<VMのIP>:~/cslab/enc/plain.csv $env:USERPROFILE\Desktop\
scp <ユーザー名>@<VMのIP>:~/cslab/enc/bom.csv   $env:USERPROFILE\Desktop\
デスクトップの2つを、それぞれ Excel でダブルクリックして開きます。
| ファイル | Excel での見え方 |
|---|---|
plain.csv(BOM 無し) | 蜷榊燕 のように化ける |
bom.csv(BOM 有り) | 正しく 名前 と出る |
📷 スクリーンショット: Excel で2つを並べて開いた画面を撮ってください。「BOM は害だ」と「BOM が必要だ」が同じ記事の中で両立する理由が、この1枚で分かります。
ここが判断の要点です。 BOM は「相手が誰か」で害にも薬にもなります。
– プログラムが読むもの(JSON・シェルスクリプト・設定ファイル・ソースコード)→ BOM 無し – Excel が読む CSV → BOM 有り(または CP932 に変換)
「常に BOM 無し」も「常に BOM 有り」も、どちらも間違いです。 出す相手で決めます。
CP932 に変換して渡す手もあります。
for_excel_sjis.csv: Non-ISO extended-ASCII textただし CP932 への変換は、変換できない文字で失敗します。 絵文字・一部の漢字(
𩸽など)・—(ダッシュ)は CP932 に存在しません。
iconv: 位置 0 に不正な入力シーケンスがありますだから、迷ったら「UTF-8 + BOM」のほうが安全です。 情報が落ちません。
改行コードも同じ話
文字コードとセットで事故になるのが改行です。 触れておきます。
crlf.txt: ASCII text, with CRLF line terminators
lf.txt: ASCII text00000000: 6c69 6e65 310d 0a6c 696e 6532 0d0a line1..line2..0d 0a の2バイトが CRLF です。 0a だけが LF です。
CRLF が具体的に何を壊すかを見ます。
./crlf.sh: 行 1: #!/bin/bash: そのようなファイルやディレクトリはありません⑥の BOM とまったく同じエラーメッセージです。 こちらは1行目の末尾に
\rが付いていて、/bin/bash\rというプログラムを探しているからです。 BOM と CRLF は、症状が同じで原因が違います。 だからxxdで1行目の「先頭」と「末尾」の両方を見るのが正しい調べ方です。
okdos2unix を使う手もあります。 使えなければ上の sed で十分です。
つまずいたところ
1. 化けた画面を見て、ファイルを作り直した(3回)
一番最初の、一番大きい遠回りです。 「化けた=壊れた」と思い込んでいたので、直せるとは考えませんでした。 ②の md5sum を先に知っていれば、1分で「壊れていない」と分かりました。 いま私が最初にやるのは xxd と nkf --guess の2つです。 作り直しは最後の手段です。
2. 化けた状態で保存して、本当に壊した
これが2番目にやった失敗で、しかもこちらは取り返しがつきませんでした。 iconv -c の -c は「変換できないバイトを捨てる」という意味です。捨てられたら終わりです。 教訓は1つ: 文字コードを触る前に cp file file.bak を取る。 例外なし。
3. <meta charset> を10回直したのに化けたままだった
HTTP ヘッダのほうが優先されることを知りませんでした。 curl -s -D - <URL> -o /dev/null でヘッダを見るのが、最初にやることでした。 HTML を疑う前に、ヘッダを見る。 ⑦の優先順位の表が、私が一番欲しかったものです。
4. length で20文字に切ったら、文字が割れた
フォームの入力を slice(0, 20) で切っていました。 絵文字が20文字目に来たとき、サロゲートペアの片方だけが残りました。 DBには入りましたが、取り出したときに � になっていました。 JSON にすると、受け取った側でパースエラーになりました。 [...s].slice(0, 20).join('') に変えて直りました。それでも家族絵文字は割れます(⑤の Intl.Segmenter)。
5. utf8 と書いた MySQL のテーブルに絵文字が入らなかった
utf8 と書いたのだから UTF-8 だろう、と思っていました。 MySQL の utf8 は3バイトまでで、4バイト文字が入りません。 名前が悪いです。 しかもテーブルを utf8mb4 に直しても化けました。 接続の charset が別に必要でした。5箇所あることを知らなかったのが原因です。
6. 「見た目が同じなのに一致しない」で半日溶かした
が の NFC / NFD です。 画面には同じ文字が出るので、目で見て比べる限り絶対に分かりません。 気づいたきっかけは JSON.stringify でした。文字列を疑ったら JSON.stringify か xxd。 目では駄目です。
7. BOM を「エディタで見えないから無い」と判断した
設定ファイルが読めなくて2時間探しました。 エディタで開いても、cat しても、正しく見えます。 xxd file | head -1 を打つまで、3バイト増えていることに気づけませんでした。 エディタの「エンコード」表示は信じてよいが、無いことの証明にはならない。 xxd が唯一の証拠です。
8. tail -c +4 を、BOM の無いファイルに使った
BOM を取る方法として覚えたので、確認せずに使いました。 BOM が無いファイルだったので、本物の3文字が消えました。 sed -i '1s/^\xef\xbb\xbf//' なら、BOM が無ければ何もしません。 こちらを使うべきでした。 「あれば消す」と「先頭3バイト消す」は別のコマンドです。
後片づけ
① 起動したままのプロセスを確認する
何か残っていたら止めます。
それでも残る場合はプロセス番号で止めます。
② BOM 付きのファイルが残っていないか探す
何も出なければ大丈夫です。 出たものは、この記事で作った練習用なので次で消えます。
③ 作業ディレクトリを消す
ascii.js  bom.csv  conf.json  conf_bom.json  count.js  cp.js  cp932.txt
crlf.sh  crlf.txt  for_excel_sjis.csv  hello.sh  lf.txt  nfc.js  page.html
page_bad.html  plain.csv  read.js  seg.js  srv.js  utf8.txt
中身を確認してから消します。
~/cslab 自体が空になっていれば、こちらも消して構いません。
④ Windows 側にコピーした CSV
⑧でデスクトップに置いた plain.csv と bom.csv を消してください。 Excel で開いたままなら閉じてから消します。
⑤ 入れたパッケージ
| パッケージ | 消すか |
|---|---|
nkf | 残す。 数百KBで、文字コードを疑うたびに使います |
ascii | 残してよい。 man ascii は今後も引きます |
消したい場合は次で消せます。
⑥ 全部片づいたか確認する
どちらも何も出なければ、片づいています。
まとめ — 理解できたこと
- 文字化けはファイルの破損ではない。 バイト列は1バイトも変わっておらず、変わったのは読み方だけ。
md5sumで確認できる。だから作り直す必要は一度も無い - 文字化けを見たら、直す前に必ずコピーを取る。 化けた状態で保存したり
iconv -cで強引に変換すると、そこで初めて本当に壊れる。�(置換文字)が出たら、その情報はもう戻らない - 文字は最初から数字だった。
A= 65、a= 97、差の32はビット1個。大文字小文字の変換が| 32でできるのは、そうなるよう番号を決めたから - ASCII は7ビット・128文字しかなく、日本語は最初から入っていない。 各国が128〜255を勝手に拡張し、その拡張の仕方が違ったことが文字化けの全原因
- コードポイント(
U+3042)と符号化方式(UTF-8 / UTF-16 / UTF-32)は別物。あの番号はどの方式でもU+3042。変わるのはバイトへの入れ方だけ。「Unicode で保存する」は方式を言っていないので意味をなさない - UTF-8 は1〜4バイトの可変長で、ASCII の範囲は1バイトのまま。 だから既存の ASCII ファイルは、何もしなくても正しい UTF-8。これが世界標準になった理由
- UTF-8 は先頭バイトのビットで「何バイト文字の何バイト目か」が分かる。 だから途中から読んでも文字の境界を復元できる。CP932 は1バイトずれると先が全部ずれる
s.lengthは文字数ではなく、UTF-16 の値の数。𩸽は 2、👨👩👧は 8。sliceで切ると文字が割れ、割れた片方は JSON で相手のパーサを落とす- 数えたいものごとに道具が違う。 バイト数は
Buffer.byteLength、コードポイント数は[...s].length、人間の1文字はIntl.Segmenter。lengthは使わない - 見た目が同じでも別の文字列になる(NFC / NFD)。
がは1文字でもか+濁点の2文字でも書ける。===はfalse。保存前・比較前にnormalize('NFC')を通す - macOS 経由のファイル名は NFD で入る。 Linux 側の
grepやfindにヒットせず、「ファイルはあるのに見つからない」になる - BOM は「見えない3バイト」(
ef bb bf)。 JSON のパースを落とし、シェルスクリプトの shebang を殺す。catでもエディタでも見えないので、xxdでしか見つからない - 「shebang を書いたのにファイルが無いと言われる」は BOM か CRLF。 症状が同じで原因が違うので、
xxdで1行目の先頭と末尾の両方を見る - BOM を取るのは
sed -i '1s/^\xef\xbb\xbf//'。tail -c +4はBOM があると確信できるときだけ(無いファイルに使うと本物の3文字が消える) - 文字コードは4層で宣言する。 BOM > HTTP ヘッダ >
<meta charset>> 推測の順で強い。BOM が無ければ、HTML をいくら直しても、ヘッダが違えば化けたまま <meta charset>は<title>より前・先頭1024バイト以内。 ブラウザはそこで見つからなければ推測に落ちる- MySQL の
utf8は3バイトまで(utf8mb3)で、絵文字が入らない。 本物の UTF-8 はutf8mb4。しかもサーバー・DB・テーブル・列・接続の5箇所にあり、接続を直さないと化ける fileもnkf --guessも推測でしかない。 統計で当てているだけで、短いファイルほど外す。正解を知っているのは作った人だけだから、外で宣言する仕組みがある- 迷ったら UTF-8(BOM無し)・LF。 例外は「Excel に渡す CSV」だけで、そこは UTF-8 + BOM。BOM は相手が誰かで害にも薬にもなる
catはファイルを表示するコマンドではなく、バイト列を端末に投げるだけ。 文字にしているのは端末で、$LANGがその設定。画面に出た文字を証拠にしない
参考リンク
- roadmap.sh — Computer Science
- Unicode 公式 — The Unicode Standard
- Unicode 公式 — UAX #15 Unicode Normalization Forms(NFC / NFD)
- Unicode 公式 — UAX #29 Text Segmentation(書記素クラスタ)
- Unicode 公式 — UTF-8, UTF-16, UTF-32 と BOM についての FAQ
- RFC 3629 — UTF-8, a transformation format of ISO 10646
- MDN — Intl.Segmenter
- MDN — String.prototype.normalize
- MDN — meta charset の指定
- MySQL 公式 — The utf8mb4 Character Set
- Node.js 公式 — Buffers and character encodings
- Ubuntu manpages — iconv(1)
次に読む
この記事は 【深掘り】コンピュータ科学 の 3 / 25 本目です。
| 記事 | |
|---|---|
| ← 前の記事 | 2進数と浮動小数点 — 0.1+0.2が0.3にならない |
| → 次の記事 | 計算量とO記法 — データが10倍で100倍遅くなる |
上から順に読めば積み上がるように並べています。 飛ばしても構いませんが、詰まったら前の回に戻ってください。
全体の順路は はじめに にあります。
roadmap.sh のどこをやっているか
- コードポイントと符号化方式は別物
- 結合文字と正規化
この記事は、上の項目を実際に手を動かして確かめる回です。
コメント