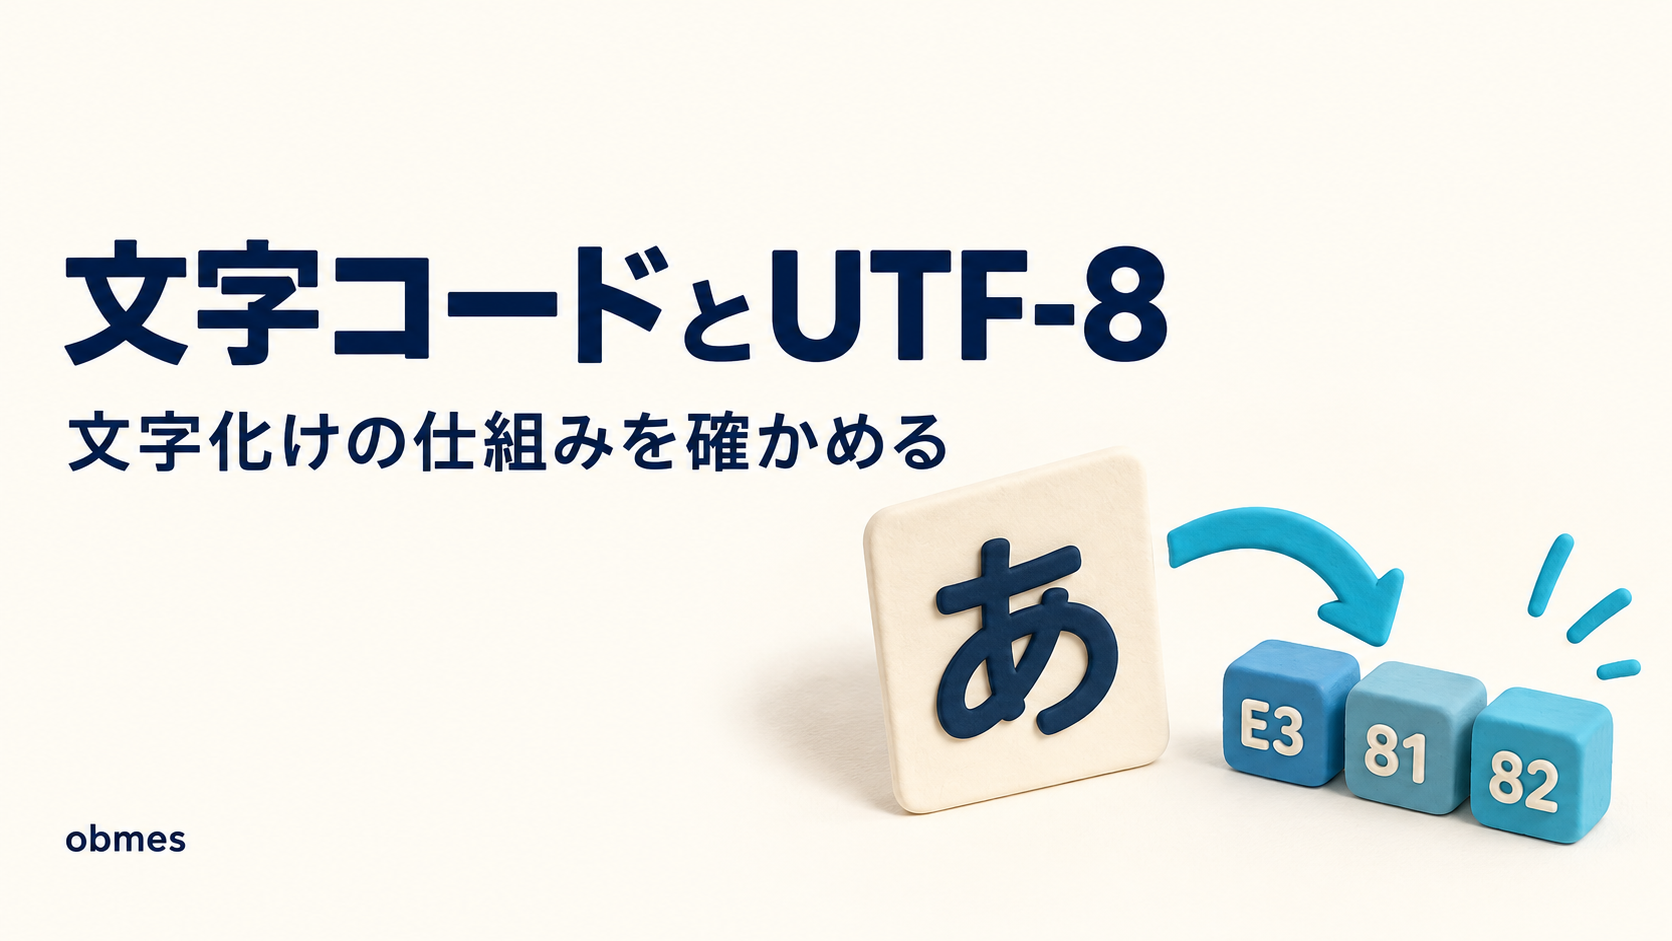
文字化けは壊れたのではなく、読み方を間違えているだけです。文字集合と符号化方式の違いを押さえて、直し方を決めます。
前回: 1つの表に全部入れると壊れる — テーブル設計と正規化 作業場所はVMの中(Ubuntu Server)です。MySQL に
appdbがあり、~/serverの Node.js が動いている状態から始めます。Windows 側を触るのは、改行コードの節だけです。
日本語を扱っていると、必ず一度は刺さります。
- ダウンロードしたCSVを開いたら
譁�ュ怜喧のような列が並んでいた - ブラウザでは正しく見えるのに、
curlで取ると崩れている - 絵文字を保存しようとしたら
Incorrect string valueでAPIが500を返した - Windows で書いたシェルスクリプトを VM に持っていったら
bad interpreterと言われた
そして、たいていは「なんとなく直り」ます。 メモ帳で開き直したら読めた。Excel のインポート画面で「UTF-8」を選んだら通った。カラムを作り直したら入った。
この記事は、その「なんとなく」をやめるための回です。
先に、いちばん大事な1文を置きます。
文字化けは、文字が壊れたのではありません。 書いたときと、読むときで、使っている「解釈の表」が違うだけです。
バイト列は1ビットも変わっていません。 E3 81 82 という3つの数字が、ある表では「あ」と読め、別の表では別の2文字に読める。それだけのことです。だから、
- 表が分かれば、ほぼ必ず元に戻せます(バイト列が残っている限り)
- 逆に、化けた状態で保存し直してしまうと、本当に戻らなくなります
「なんとなく直った」がまずいのは、この2つ目の分かれ道を通ったかどうかが分からないからです。 目の前の画面が読めるようになっただけで、データベースの中身は壊れたまま、ということが普通に起きます。
なので、この記事では推測を一切しません。 バイトを直接見ます。
似たタイトルの記事があります。役割が違います。 この記事は化けたときに直す手順を扱います。文字コードとUTF-8の仕組み|文字化けが読み方の問題である理由 はバイト列を見ながら、化けている最中に何が起きているかを扱います。
対象レベル: 初級〜中級 / 区分: 必修
この記事でわかること
- 文字化けはデータの破損ではなく、解釈の食い違いであること。バイト列が残っていれば戻せるが、化けた状態で保存し直すと戻せなくなること
- 「文字コード」と呼ばれているものは、実は2階建てであること。Unicode(文字の一覧)と UTF-8(それをバイトに直す方法)は別の話だということ
- MySQL の
utf8は UTF-8 ではないこと。utf8mb3の別名で、絵文字が入らないこと - 照合順序(collation)は「同じとみなす範囲」の設定であること。
utf8mb4_0900_ai_ciは左から順に読めること - 索引には「文字数」ではなく「バイト数」の上限があること。
VARCHAR(191)という謎の数字の出どころ - 改行コードと BOM は、目に見えないのに動作を壊すこと。
fileとodで必ず見えるようになること - HTTP ヘッダと
<meta charset>は、勝つ順番が決まっていること - JavaScript の文字列は UTF-16 で、
.lengthは文字数ではないこと。絵文字を数えると合わない理由 - 結論はいつも同じで「全部 UTF-8 に統一し、変換は入口と出口だけでやる」こと
この記事でやること
odで「あ」のバイトを直接見る。 ASCII が1バイト、日本語が3バイトであることを目で確認するiconvでわざと化けさせる。 UTF-8 を Shift_JIS として読み、逆もやる。化け方のパターンから元を当てて直す- MySQL で絵文字を
Incorrect string valueで弾かせる。utf8mb3の表をutf8mb4に直し、索引の長さ制限にもわざとぶつかる - CRLF のシェルスクリプトと、BOM 付きのシェルスクリプトを作って、実際に動かなくする。 そして直す
- HTTP ヘッダと
<meta charset>を食い違わせて、どちらが勝つかを確かめる - Node.js で
"𩸽".lengthを打って、2 が返るのを見る
先に知る言葉
この記事で初めて出てくる言葉です。 基本的な言葉は用語集にもまとめてあります。
| 言葉 | 意味 |
|---|---|
| バイト | 0〜255 の数字1つ。ファイルの中身は、突き詰めるとこれが並んでいるだけ |
| 符号化文字集合 | 「どの文字に、どの番号を振るか」の一覧表。 Unicode、JIS X 0208 など |
| コードポイント | 上の表で文字に振られた番号。「あ」は U+3042 |
| 符号化方式(エンコーディング) | その番号を、実際に何バイトでどう書くかの決まり。UTF-8、UTF-16 など |
| UTF-8 | Unicode の番号を1〜4バイトで書く方式。 ASCII と互換で、いま事実上の標準 |
| ASCII | 英数字と記号だけの、1バイト64年ものの表。0〜127 番だけを使う |
| Shift_JIS / CP932 | Windows で長く使われた日本語の方式。 厳密には CP932 は Shift_JIS の Microsoft 拡張 |
| EUC-JP | 昔のUNIXで使われた日本語の方式。 いまも古いシステムで出会う |
| 文字化け(mojibake) | 書いたときと読むときの符号化方式が違うために、別の文字として表示される状態 |
| BOM | ファイル先頭に付く「見えない3バイト」(EF BB BF)。「これは UTF-8 です」という印 |
| 改行コード | 行の終わりを表すバイト。LF(0A)が Linux、CRLF(0D 0A)が Windows |
| サロゲートペア | UTF-16 で、1文字を2つの単位に分けて書くやり方。JavaScript の .length が狂う原因 |
| 照合順序(collation) | 文字列を「同じ」「順番はこっちが先」と判定するときの規則。 大文字小文字を区別するかなど |
utf8mb4 | MySQL の本物の UTF-8。 1文字最大4バイト。絵文字が入る |
utf8mb3 | MySQL の中途半端な UTF-8。 1文字最大3バイト。絵文字が入らない。旧称 utf8 |
| ロケール | OS に「どの言語・どの文字コードで動くか」を伝える設定。 LANG 環境変数 |
この記事を通して言いたいのは、たった1文です。 「バイト列と、それを読む表は、別々に持ち運ばれる」。 ファイルにもデータベースにも HTTP にも、「これは何の表で書いたか」を書いておく欄があるか、無いかのどちらかです。 欄が無い場所(ただのテキストファイル)では、受け取った側が推測するしかありません。 文字化けは、その推測が外れた瞬間に起きます。
① 文字が数字であることを、実際に見る
説明から入りません。 まずバイトを見ます。
VMの中で、作業用のフォルダを作ります。
まず英字を見る
od はファイルやパイプの中身を数字として表示するコマンドです。基本コマンドの回では出てきませんでしたが、Ubuntu には最初から入っています(coreutils)。
-An は「左端のアドレス(何バイト目か)を出さない」、-tx1 は「1バイトずつ16進数で出す」という意味です。echo -n の -n は末尾に改行を付けないためで、これを忘れると必ず 0a が1つ余分に出ます。
出力はこうなります。
4141 は16進数で、10進数の 65 です。 これが「A」に振られた番号で、世界中どこでも 65 は A です。これが ASCII です。
次に日本語を見る
e3 81 82「あ」は3バイトです。 「A」は1バイトでした。同じ「1文字」なのに、長さが違います。
ここが、日本語を扱う人が最初につまずく地点です。 「10文字までしか入らない欄」に日本語を10文字入れると溢れる、というのは、この差から来ています。
xxd のほうが読みやすい、という人もいます。Ubuntu Server の最小構成には入っていないことがあるので、無ければ入れてください(無ければ od のままで構いません)。
バイト数だけ数えたいなら、これが一番速いです。
155文字で15バイト。 1文字3バイトです。
なぜ日本語は複数バイトなのか
1バイトで表せる種類は 256 通りしかありません。
英語なら、大文字26+小文字26+数字10+記号と制御文字で、128通りに全部収まりました。 これが ASCII です。日本語は漢字だけで数万文字あります。 256 に収まるはずがありません。
だから複数バイトを使います。 ここで問題が1つ出ます。
e3 81 82を「3バイトで1文字」と読むのか、「1バイトずつ3文字」と読むのか、バイト列自身は教えてくれません。
UTF-8 は、ここを非常にうまく設計してあります。 バイトの先頭ビットを見るだけで、それが「1文字の先頭」なのか「続き」なのかが分かるようになっています。
| 先頭バイト | 意味 | 例 |
|---|---|---|
00〜7F | 1バイトで1文字(ASCII そのまま) | 41 = A |
C2〜DF | 2バイト文字の1バイト目 | ラテン文字のアクセント付きなど |
E0〜EF | 3バイト文字の1バイト目 | e3 81 82 = あ |
F0〜F4 | 4バイト文字の1バイト目 | 絵文字、一部の漢字 |
80〜BF | 続きのバイト(単独では現れない) | 81、82 |
この表から、UTF-8 の重要な性質が2つ出てきます。
- ASCII の範囲(
00〜7F)は、UTF-8 でもまったく同じバイト。 だから英数字だけのファイルは、UTF-8 として読んでも Shift_JIS として読んでも同じに見えます - 途中のバイトを見れば、文字の切れ目に戻れる。 ファイルの真ん中から読み始めても復帰できます
そして、1つ目の性質が厄介でもあります。
英数字だけのファイルは、文字コードを間違えても化けません。 だから「うちのシステムは大丈夫」と思ったまま、日本語や絵文字が来た日に初めて壊れます。
② 文字集合と符号化方式は別の話
ここが、この記事でいちばん誤解されている部分です。
「文字コードは何ですか」と聞かれて「Unicode です」と答えるのは、厳密には質問に答えていません。 2階建てになっているからです。
| 階 | 名前 | 決めていること | 例 |
|---|---|---|---|
| 1階 | 符号化文字集合(文字集合) | どの文字に、どの番号を振るか | Unicode、JIS X 0208、ASCII |
| 2階 | 符号化方式(エンコーディング) | その番号を、実際にどうバイトに書くか | UTF-8、UTF-16、UTF-32 |
「あ」を例に、2階建てを通してみます。
- 1階(Unicode): 「あ」の番号は
U+3042と決まっている - 2階(UTF-8):
U+3042をE3 81 82の3バイトで書く - 2階(UTF-16): 同じ
U+3042を30 42の2バイトで書く
Unicode と UTF-8 は「同じもの」ではありません。 Unicode は番号表、UTF-8 は書き方です。 同じ Unicode の番号を、UTF-8 と UTF-16 は違うバイトで書きます。
「Unicode で保存」というボタンがあったら、それはたいてい UTF-16 のことです(Windows のメモ帳が長くそう表記していました)。この曖昧さが、そのまま事故になります。
日本の古い文字コードも、同じ2階建てで整理できます。
| 1階(文字集合) | 2階(符号化方式) | どこで会うか |
|---|---|---|
| Unicode | UTF-8 | いまの標準。 Web、Linux、JSON |
| Unicode | UTF-16 | Windows の内部、JavaScript の文字列 |
| JIS X 0208 など | Shift_JIS / CP932 | Windows の日本語、古いCSV、Excel |
| JIS X 0208 など | EUC-JP | 古いUNIX系サーバー、古い掲示板 |
| JIS X 0208 など | ISO-2022-JP | メール(いまも残っている) |
「Shift_JIS と CP932 の違い」も、ここで片付けておきます。
- Shift_JIS は元の規格
- CP932 は Microsoft が独自の文字(丸数字の①、ローマ数字のⅠ、㈱ など)を足した拡張版
- Windows で作られたファイルは、ほぼ CP932 です
なので、
iconvで日本語ファイルを扱うときはSHIFT_JISではなくCP932を指定してください。SHIFT_JISを指定すると、①や㈱のところだけ変換に失敗します。 これは実際にハマります。
③ わざと化けさせる
読んで分かった気になるのがいちばん危ないので、自分で壊します。
iconv は文字コードを変換するコマンドで、Ubuntu には最初から入っています。使い方は3つ覚えれば足ります。
| 書き方 | 意味 |
|---|---|
iconv -f A -t B ファイル | A で書かれていると思って読み、B で書き直す |
iconv -l | 使える文字コード名の一覧(大量に出ます) |
-c | 変換できないバイトを、エラーにせず捨てる(情報が消える) |
-f(from)が「読むときの表」、-t(to)が「書くときの表」です。文字化けは -f を間違えた状態そのものです。
材料を3つ作る
同じ内容が、3つの違うバイト列になっています。 サイズを見てください。
UTF-8 は1文字3バイト、CP932 と EUC-JP は1文字2バイトなので、日本語のファイルは UTF-8 のほうが大きくなります。 これは UTF-8 の欠点としてよく挙がる点ですが、いまは気にする理由がありません。
中身を見比べます。
UTF-8 の「文」は e6 96 87、CP932 の「文」は 95 b6。 同じ文字が、まったく違う数字になっているのが見えます。
化けさせる(UTF-8 を Shift_JIS として読む)
端末が UTF-8 なので、CP932 のファイルをそのまま表示すると化けます。
? や ◆ のような記号が並ぶはずです。 これは、CP932 のバイト列を UTF-8 として読もうとして、UTF-8 のルールに合わないバイトを「読めない」と表示している状態です。
逆をやります。UTF-8 のファイルを「CP932 だと思って」読ませます。
譁�ュ怜喧 のような、見覚えのある形が出ます。 実際に出る文字は環境で変わりますが、特徴は変わりません。
-cを付けたのは、CP932 として解釈できないバイトが必ず混ざるからです。-cは、そのバイトを黙って捨てます。 化けを再現するためだけに使っています。本番のデータに-cを使ってはいけません。
化け方には、はっきりした特徴がある
さっきの 譁 や 縺 は、ランダムではありません。
UTF-8 のひらがなは、必ず e3 81 xx か e3 82 xx から始まります。 これを2バイトずつ区切って CP932 で読むと、e3 81 → 縺、e3 82 → 繧 に固定的に化けます。だから、
「縺」「繧」だらけの文字列を見たら、元は UTF-8 のひらがなです。
この対応表を覚える必要はありません。 覚えるのは「化け方は一意に決まる」という事実だけで十分です。次の節で、そこから逆算します。
④ 化け方から元の文字コードを当てて、直す
現場では、化けた文字列だけを渡されます。 「これ直してください」と。そのときに使う表がこれです。
| 化けた見た目 | 元の文字コード | 読んだ側の文字コード |
|---|---|---|
| 「縺」「繧」「譁」「蜿」が並ぶ | UTF-8 | CP932 / Shift_JIS |
| 「�」(黒いひし形に ?)だらけ | CP932 / EUC-JP | UTF-8 |
| 「ã」「Ã」「â」「¦」などラテン文字 | UTF-8 | ISO-8859-1 / Windows-1252 |
半角カタカナ(ニホン のような)が並ぶ | EUC-JP | CP932 / Shift_JIS |
| 「?」が1文字ずつ、数がちょうど文字数 | 変換時に捨てられた(-c や ? 置換) | もう戻せない |
いちばん下の行が、この記事でいちばん言いたいことです。
上の4つは戻せます。バイト列が残っているからです。 いちばん下だけは戻せません。 変換できない文字を
?にして保存した時点で、情報そのものが消えています。
「なんとなく直った」が危ないのは、この2つを見分けないまま保存ボタンを押してしまうからです。
手順1: まず推測させる(ただし信じない)
file は中身を見て種類を推測するコマンドです。文字コードだけを知りたいときは、こう聞きます。
utf8.txt は utf-8 と当ててくるはずです。 一方、sjis.txt は unknown-8bit や iso-8859-1 のような、明らかに違う答えが返ることがあります。
fileの答えは推測です。 日本語の短いファイルは、かなりの確率で外します。 「これで確定」ではなく「候補を1つもらった」と考えてください。
もう1つ、nkf という日本語専用の判定コマンドがあります。 こちらのほうが日本語には強いです。
Shift_JIS、EUC-JP、UTF-8 と、それぞれの改行コードまで返ってきます。
手順2: 候補を総当たりして、読めるものを選ぶ
推測が外れたときは、力技で確かめます。 これがいちばん確実です。
日本語として読める行が1つだけ出ます。 それが正解です。「変換できませんでした」と出た候補は、そもそもその文字コードとして成立していないということで、これも十分な情報です。
for の書き方はシェルスクリプトの回でやったものと同じです。2>/dev/null はエラーメッセージだけ捨てる指定です。
手順3: 直して保存する
正解が CP932 だと分かったら、UTF-8 に直します。
nkf なら、こう書けます。
-w が「UTF-8 で出す」です(-s が Shift_JIS、-e が EUC-JP、-j が ISO-2022-JP)。
元のファイルに上書きしないでください。
iconv -f CP932 -t UTF-8 sjis.txt > sjis.txtは、リダイレクトが先にファイルを空にするので、中身が消えます。 必ず別名に出して、読めることを確認してから差し替えてください。
nkf には --overwrite がありますが、これも一度コピーを取ってから使ってください。
⑤ MySQL の utf8 は UTF-8 ではない
ここからが、この記事の本丸です。
MySQLの回で CREATE TABLE を打ちました。あのとき文字コードを指定しなかったのは、いまの MySQL 8.0 の既定が utf8mb4 で、たまたま正解だったからです。
ネットの古い記事を見ると、こう書いてあります。
CREATE TABLE t (...) CHARACTER SET utf8;この
utf8は、UTF-8 ではありません。utf8mb3の別名で、1文字あたり最大3バイトしか扱えません。
UTF-8 は最大4バイトです。 つまり utf8 は UTF-8 の一部しか入らない、名前だけ UTF-8 の別物です。そして4バイトになるのは、絵文字と、一部の漢字です。
実際に落とします。VMで MySQL に入ります。
まず、いまの既定を確認します。
SHOW VARIABLES LIKE 'character\_set\_%';
SHOW VARIABLES LIKE 'collation\_%';
\_ になっているのは、LIKE では _ が「任意の1文字」を意味してしまうためのエスケープです。
MySQL 8.0 なら character_set_server は utf8mb4、collation_server は utf8mb4_0900_ai_ci のはずです。
わざと古い形で作る
この記事で作る表は、すべて d_ で始めます。 d は draft のつもりで、最後にまとめて消せば元通りになります。既存の tasks や users には触りません。
USE appdb;

CREATE TABLE d_enc3 (
  id   INT AUTO_INCREMENT PRIMARY KEY,
  body VARCHAR(100)
) CHARACTER SET utf8mb3;
作った直後に、MySQL 自身が何と言っているか確認します。
SHOW CREATE TABLE d_enc3\GDEFAULT CHARSET=utf8mb3 と返ります。 MySQL 8.0 の新しめのバージョンでは、utf8 と書いても utf8mb3 に置き換えて記録し、「utf8 は将来の非推奨」という警告を出します。
SHOW WARNINGS;日本語は入る。絵文字で落ちる
INSERT INTO d_enc3 (body) VALUES ('日本語はふつうに入ります');
SELECT * FROM d_enc3;
入ります。 ここが罠です。日本語のほとんどは3バイトなので、utf8mb3 でも問題なく動いてしまいます。
INSERT INTO d_enc3 (body) VALUES ('寿司🍣');ERROR 1366 (HY000): Incorrect string value: '\xF0\x9F\x8D\xA3' for column 'body' at row 1このエラーは、日本語を扱う人が本番で最初に踏む地雷です。 開発中は誰も絵文字を入れないので、気づきません。 ユーザーが投稿した瞬間に 500 が返ります。
エラーメッセージの \xF0\x9F\x8D\xA3 を見てください。 ①でやった表を思い出すと、F0 で始まるのは4バイト文字です。MySQL は「4バイト文字が来たが、この列は3バイトまでだ」と、正確に言っています。
バイト数を数えて確かめる
MySQL には「文字数」と「バイト数」の両方を返す関数があります。
SELECT 'あ'  AS c, CHAR_LENGTH('あ')  AS 文字数, LENGTH('あ')  AS バイト数
UNION ALL
SELECT 'A',        CHAR_LENGTH('A'),        LENGTH('A')
UNION ALL
SELECT '🍣', CHAR_LENGTH('🍣'), LENGTH('🍣');| c | 文字数 | バイト数 |
|---|---|---|
| あ | 1 | 3 |
| A | 1 | 1 |
| 🍣 | 1 | 4 |
CHAR_LENGTHが文字数、LENGTHがバイト数です。VARCHAR(100)の 100 は「文字数」です(MySQL 5.0 以降)。バイト数ではありません。 ここも混乱しやすい点です。
なぜ4バイト必要なのか。 絵文字は Unicode の番号がとても大きい領域(U+1F363 など)にあり、3バイトでは番号が入りきらないからです。utf8mb3 が扱えるのは U+FFFF までです。
⑥ 照合順序 —— 何を「同じ」とみなすか
utf8mb4 と一緒に必ず出てくるのが、utf8mb4_0900_ai_ci のような呪文です。
これは文字コードではありません。 「2つの文字列を比べるときの規則」です。
文字コード(charset)= どう保存するか 照合順序(collation)= どう比べるか・どう並べるか
この2つは必ずセットで指定します。
呪文を左から読む
utf8mb4_0900_ai_ci は、4つの部品の連結です。
| 部品 | 意味 |
|---|---|
utf8mb4 | 対象の文字コード |
0900 | Unicode 9.0.0 の比較規則を使う(数字はバージョン) |
ai | accent insensitive = アクセント記号の違いを無視する(café = cafe) |
ci | case insensitive = 大文字小文字の違いを無視する(ABC = abc) |
反対語も同じ形です。
| 部品 | 意味 |
|---|---|
as | accent sensitive = アクセントを区別する |
cs | case sensitive = 大文字小文字を区別する |
bin | バイト列をそのまま比較。 何も無視しない |
ks | kana sensitive = ひらがなとカタカナを区別する(日本語向けの ja 系に付く) |
実際に比べてみる
SELECT
  'ABC' COLLATE utf8mb4_0900_ai_ci = 'abc' AS ci,
'ABC' COLLATE utf8mb4_0900_as_cs = 'abc' AS cs;| ci | cs |
|---|---|
| 1 | 0 |
同じ2つの文字列が、規則によって「同じ」にも「違う」にもなります。
これが効いてくる場面は、はっきりしています。
- ログインのメールアドレス:
Taro@example.comとtaro@example.comを同じ人とみなすか - ユーザー名の重複チェック:
adminとAdminの登録を両方許すか - 検索: 全文検索の回で「日本語には単語の区切りが無い」という話をしましたが、その前段として「ひらがなとカタカナを同じ語とみなすか」も、ここで決まります
日本語のかな・全角半角まで区別したいときは、日本語専用の照合順序があります。
SELECT 'ア' COLLATE utf8mb4_0900_ai_ci     = 'あ' AS 既定,
       'ア' COLLATE utf8mb4_ja_0900_as_cs_ks = 'あ' AS かな区別;
既定の 0900_ai_ci は、ひらがなとカタカナ、全角と半角を「同じ」とみなします。 検索では便利ですが、「アカウント名が別人と衝突する」といった形で問題になることもあります。 どちらが正しいかは要件次第で、大事なのは「無自覚に決まっている」状態をやめることです。
迷ったら
utf8mb4_0900_ai_ci(MySQL 8.0 の既定)で構いません。 やってはいけないのは、テーブルごとに違う照合順序を混ぜることです。JOINの条件で照合順序が食い違うと、Illegal mix of collationsというエラーで落ちます。
⑦ 既存テーブルを直す —— と、索引の長さ制限
d_enc3 を utf8mb4 に直します。
効かない直し方を先に見る
ネットで見つかるこれは、半分しか効きません。
ALTER TABLE d_enc3 DEFAULT CHARACTER SET utf8mb4;SHOW CREATE TABLE d_enc3\Gテーブルの DEFAULT CHARSET は utf8mb4 になりますが、body 列は utf8mb3 のままです。
INSERT INTO d_enc3 (body) VALUES ('やっぱり寿司🍣');まだ ERROR 1366 で落ちます。
DEFAULT CHARACTER SETは「これから追加する列の既定」を変えるだけです。 既存の列は1つも変わりません。 ここで「直したのに直らない」と数時間溶かすのが定番です。
効く直し方
ALTER TABLE d_enc3 CONVERT TO CHARACTER SET utf8mb4 COLLATE utf8mb4_0900_ai_ci;
SHOW CREATE TABLE d_enc3\G
INSERT INTO d_enc3 (body) VALUES ('やっぱり寿司🍣');
SELECT * FROM d_enc3;
今度は入ります。 CONVERT TO はすべての文字列型の列を作り直します。
CONVERT TOは、テーブル全体を作り直す重い操作です。 行数が多いと、その間ロックがかかって止まります。 パフォーマンス改善の回でやったように、本番では必ず所要時間を見積もってから、利用の少ない時間に流してください。 そして、先にバックアップを取ってください。mysqldumpを使うときは--default-character-set=utf8mb4を必ず付けます。付けないと、バックアップの時点で化けます。
索引の長さ制限にぶつかる
文字コードを4バイトに広げると、副作用があります。索引です。
CREATE TABLE d_enc_idx (
  v VARCHAR(1000) NOT NULL,
  KEY (v)
) CHARACTER SET utf8mb4;
ERROR 1071 (42000): Specified key was too long; max key length is 3072 bytes索引に入れられるのは 3072 バイトまで(InnoDB の DYNAMIC 行形式)です。VARCHAR(1000) を utf8mb4 で作ると、最悪 1000 × 4 = 4000 バイトになるので、MySQL は「入らない可能性がある」時点で拒否します。
実際のデータが英数字だけでも関係ありません。 索引の設計は「最悪の場合」で決まります。
直し方は2つです。
CREATE TABLE d_enc_idx (
  v VARCHAR(1000) NOT NULL,
  KEY (v(191))
) CHARACTER SET utf8mb4;
v(191) は「先頭191文字だけを索引に入れる」という指定です(前方一致には効きますが、完全一致の重複防止には使えません)。もう1つは、そもそも列を短くすることです。
VARCHAR(191)という中途半端な数字を、古い WordPress や Laravel の記事で見たことがあるかもしれません。 あれの出どころがここです。 昔の MySQL(5.6 以前の既定)は索引の上限が 767 バイトでした。 767 ÷ 4 = 191.75 → 191文字。 つまり 「utf8mb4 でUNIQUEを張れる最大の文字数」が 191 でした。 いまの 8.0 では 3072 バイト(= 768文字)まで入るので、191 を機械的に真似する必要はありません。
この話は ORMとマイグレーションの回にも効いてきます。 Knex でテーブルを作るとき、マイグレーションファイルに文字コードを書いておかないと、環境によって違う文字コードで作られます。
exports.up = (knex) =>
  knex.schema.createTable('d_enc_knex', (t) => {
    t.increments('id');
    t.string('body', 200);
    t.charset('utf8mb4');
    t.collate('utf8mb4_0900_ai_ci');
  });
⑧ 接続の文字コード —— 二重エンコードという最悪の事故
⑤〜⑦を全部やっても、まだ化けることがあります。
データベースの中の文字コードと、アプリからデータベースへの「通り道」の文字コードは、別の設定だからです。
通り道が違うと、MySQL は受け取ったバイトを「言われた文字コードのつもり」で解釈し直します。
SHOW VARIABLES LIKE 'character\_set\_client';
SHOW VARIABLES LIKE 'character\_set\_connection';
SHOW VARIABLES LIKE 'character\_set\_results';
この3つが utf8mb4 になっていれば正常です。 揃っていなければ、接続してすぐこれを打ちます。
SET NAMES utf8mb4;Node.js から繋ぐとき(Node.js から繋いだ回の設定です)は、接続設定に明示的に書いてください。
const pool = mysql.createPool({
  host: '127.0.0.1',
  user: process.env.DB_USER,
  password: process.env.DB_PASSWORD,
  database: 'appdb',
  charset: 'utf8mb4',
});
「既定でいい感じにしてくれるはず」と思わないでください。 既定値はライブラリのバージョンで変わります。 バージョンを上げた日に化け始める、という事故が起きます。明示的に書いてあれば、上げても変わりません。
二重エンコード(double encoding)
この設定を間違えたまま運用すると、いちばん厄介な状態になります。
- アプリが UTF-8 のバイト(
E3 81 82)を送る - 接続が
latin1だと宣言しているので、MySQL は「3つのラテン文字が来た」と解釈する - MySQL は、その3つのラテン文字を UTF-8 に変換して保存する
- 結果、6バイトくらいの、意味のない「正しい UTF-8」が保存される
ここが最悪な点です。 保存されたデータは、UTF-8 として完全に正しいバイト列です。 だから
fileも MySQL も「正常」と言います。 人間が読むと化けている。それだけが手がかりです。
直し方はありますが、危険です。 バイト列に戻してから、正しい文字コードとして読み直します。
SELECT CONVERT(BINARY(CONVERT(body USING latin1)) USING utf8mb4) FROM d_enc3;この SQL は、必ず
SELECTで結果を目視してからUPDATEにしてください。 実行前に必ずバックアップを取ってください。 間違った文字コードを指定してUPDATEすると、今度こそ戻せなくなります。 そして、これは対症療法です。 先に⑧の接続設定を直さないと、明日また同じデータが増えます。
⑨ 改行コード —— CRLF と LF
ここから、目に見えないバイトの話に移ります。
「行の終わり」を表すバイトが、OS によって違います。
| 名前 | バイト | どこ | 由来 |
|---|---|---|---|
| LF | 0A | Linux、macOS、Web | Line Feed(紙を1行送る) |
| CRLF | 0D 0A | Windows | Carriage Return(印字位置を左端に戻す)+ LF |
タイプライターの動作が、そのまま残っています。
実際に壊す
Windows で書いたつもりのスクリプトを、VM の中で作ってみます。
bash: ./crlf.sh: /bin/bash^M: bad interpreter: No such file or directoryエラーメッセージの
^Mが、0D(CR)の表示です。 Linux は1行目を「/bin/bashを使え」ではなく「/bin/bash(CR)を使え」と読みました。 そんな名前のプログラムは無いので、正直に「無い」と言っています。
これはシェルスクリプトの回で書いたスクリプトを、Windows のエディタで編集して戻したときに、そのまま起きます。
見えるようにする
crlf.sh: Bourne-Again shell script, ASCII text executable, with CRLF line terminatorsfile は、ちゃんと言ってくれます。 もっと確実に見たいときは、cat -A です。
行末が ^M$ になっています。 $ が行末の印で、その手前に ^M があるのが CRLFです。LF だけなら $ だけです。テキスト処理の回でやった sed や grep が「なぜか一致しない」ときも、たいていこれが原因です。
直す
hello と出れば直っています。 専用のコマンドもあります。
Git の core.autocrlf
チームで開発すると、これが毎日起きます。 そこで Git には、チェックアウト時とコミット時に改行を自動変換する仕組みがあります。
| 値 | 動き | 誰向けか |
|---|---|---|
true | チェックアウト時に CRLF、コミット時に LF | Windows |
input | チェックアウトは変換なし、コミット時に LF | Linux / macOS |
false | 何もしない | 全員が同じ設定のとき |
Gitの導入の回で設定した項目の1つです。
ただし、
core.autocrlfは各自の PC の設定です。 リポジトリには保存されません。 新しく参加した人が設定していなければ、その人だけが CRLF をコミットします。
リポジトリ側で決めたいときは、.gitattributes を置きます。こちらが本命です。
* text=auto eol=lf
*.sh text eol=lf
*.bat text eol=crlf
*.png binary
.gitattributes はリポジトリに入るので、全員に効きます。 チーム開発の回でやったレビューの前に、これを1枚置いておくだけで、「改行コードだけの差分で全行が赤くなる」プルリクエストが消えます。
すでに CRLF が混ざったリポジトリで .gitattributes を入れたときは、一度そろえ直します。
--renormalizeは、全ファイルを新しい規則で登録し直します。 巨大な差分が1つできますが、それきりです。 コミットメッセージに「改行コードの統一のみ」と書いておいてください。
⑩ BOM —— 先頭の見えない3バイト
もう1つの「見えないバイト」です。
BOM は Byte Order Mark の略で、ファイルの先頭に付く EF BB BF の3バイトです。「このファイルは UTF-8 です」という印として、主に Windows の文化で使われてきました。
印としては便利です。推測しなくて済むからです。 問題は、Linux 側のプログラムが「先頭は #! から始まる」と信じていることです。
実際に壊す
エラーが出ます。 文言は環境で変わりますが、「そんなコマンドは無い」系のことを言われます。
理由は単純です。
#!がファイルの先頭に無いからです。 先頭にあるのはEF BB BFで、それは#ではありません。 だから「1行目はシェバングではない」と判定され、1行目はただのコマンドとして実行されようとします。
見えるようにする
ef bb bfUTF-8 Unicode (with BOM) text のように、with BOM が付きます。
catやnanoや VS Code で開いても、BOM は見えません。odとfileだけが教えてくれます。 ここが「見た目は完全に正しいのに動かない」の正体です。
直す
1s は「1行目に対してだけ置換する」という指定です。
BOM が壊すもの
| 壊れるもの | 症状 |
|---|---|
| シェルスクリプト | bad interpreter / コマンドが見つからない |
| JSON | JSON.parse が Unexpected token で落ちる。目で見ると完璧に正しい JSON |
| PHP・テンプレート | 出力の先頭に見えない文字が混ざり、HTTPヘッダの送信に失敗する |
| CSV | 1列目の見出しの先頭に見えない文字が付き、列名の一致に失敗する(逆に、Excel は BOM が無いと日本語を CP932 と誤認します) |
| 設定ファイル | 1行目のキーだけ認識されない |
では BOM は付けるべきか、付けないべきか。
Linux 側で扱うファイルには、付けません。 Excel で開かせる CSV には、付けます。 Excel は BOM が無い UTF-8 の CSV を CP932 と誤認して化けさせるからです。 つまり「入口と出口だけ変換する」という、この記事の結論そのままです。
もう1つ、Windows 側での注意です。
Windows の PowerShell で
>を使ってファイルを作ると、UTF-8 とは限りません。 バージョンによって UTF-16 になったり、BOM 付き UTF-8 になったりします。 VM の中で使うファイルを、Windows 側のリダイレクトで作らないでください。 VS Code から VM を直接編集する回でやったように、VM の中のファイルを直接編集するのが確実です。
VS Code は、右下のステータスバーに UTF-8 と LF を表示します。 BOM が付いていると UTF-8 with BOM と出ます。 クリックすれば、その場で変換できます。 この記事の内容の8割は、あの2つの表示を読めるかどうかです。
⑪ HTTP と HTML —— どちらが勝つか
Web では、文字コードの申告場所が3つあります。
- HTTP レスポンスヘッダ:
Content-Type: text/html; charset=utf-8 - HTML の中:
<meta charset="utf-8"> - BOM
3つが食い違ったらどうなるか。順番が決まっています。
| 順位 | 申告場所 | 備考 |
|---|---|---|
| 1(最強) | BOM | 付いていたら、他を全部無視して UTF-8 |
| 2 | HTTP の charset | サーバーが言ったことが、ファイルの中身より強い |
| 3 | <meta charset> | 先頭1024バイト以内に無いと読まれない |
| 4 | ブラウザの推測 | 当てになりません |
覚えるのはここだけです。 HTTP ヘッダは
<meta charset>より強い。 だから「HTML に<meta charset="utf-8">と書いてあるのに化ける」が起きます。 サーバーが違うことを言っています。
実際に確かめる
nginx の回で立てたサーバーを使います。
charset が付いていないか、charset=utf-8 と付いているはずです。 nginx で明示するには、サイトの設定ファイルの server { ... } の中に1行足します。
charset utf-8;nginx -t は設定の文法チェックです。startとenableの回でやったとおり、reload する前に必ず通します。
わざと食い違わせる
まず、正しく表示されることを確認します。 ブラウザで http://<VMのIPアドレス>/enc.html を開いてください。
次に、サーバーに嘘をつかせます。
charset utf-8; を charset euc-jp; に書き換えて、reload します。
ブラウザを再読み込みすると、化けます。 HTML には <meta charset="utf-8"> と書いてあるのに、です。
開発者ツールの回でやった Network タブを開いて、レスポンスヘッダを見てください。 Content-Type: text/html; charset=euc-jp と出ています。サーバーの申告が勝っています。
確認したら、必ず charset utf-8; に戻して reload してください。
ここで、HTMLの基本の回の話が効いてきます。
<meta charset="utf-8">は、<head>のできるだけ先頭に書いてください。 ブラウザは先頭 1024 バイトしか探しません。 前に長いコメントや大きな<script>を置くと、見つけてもらえません。
API を作るときも同じです。 REST API 設計の回で Content-Type: application/json を返しました。
JSON は、仕様上 UTF-8 と決まっています。 だから
charsetを書く必要は本来ありません。 ただし「UTF-8 で送る」ことは、あなたの責任です。 仕様がそう決めているだけで、勝手に変換はされません。
⑫ JavaScript の文字列は UTF-16
最後は、JavaScript の回の続きです。
JavaScript の文字列は UTF-8 ではありません。UTF-16 です。 これは仕様で決まっていて、変えられません。
VM で Node.js を対話モードで起動します。
"あ".length1 です。 問題ありません。
"𩸽".length2 が返ります。
𩸽(ほっけ)は1文字です。それなのに.lengthは 2 を返します。
理由は UTF-16 の作りです。
- UTF-16 は、1文字を2バイトで書くのが基本でした
- 2バイトで表せるのは
U+0000〜U+FFFFまで 𩸽はU+29E3D。入りません- そこで「2つの単位に分けて書く」というルールを後から足しました。これがサロゲートペアです
JavaScript の .length は、文字数ではなく「UTF-16 の単位の数」を返します。
"𩸽".codePointAt(0).toString(16)
[..."𩸽"].length
Buffer.byteLength("𩸽")| 式 | 結果 | 意味 |
|---|---|---|
"𩸽".length | 2 | UTF-16 の単位の数 |
[..."𩸽"].length | 1 | コードポイントの数(人間の感覚に近い) |
"𩸽".codePointAt(0).toString(16) | 29e3d | Unicode の番号 |
Buffer.byteLength("𩸽") | 4 | UTF-8 にしたときのバイト数 |
[...文字列] のスプレッド構文は、コードポイント単位で分解します。 .split("") は UTF-16 単位で切るので、サロゲートペアが真っ二つになります。
"𩸽定食".slice(0, 1)壊れた半分が返ります。 文字数で切る処理を書くときは、.slice() や .substring() をそのまま使ってはいけません。
絵文字はもっと合わない
"👨👩👧".length
[..."👨👩👧"].length| 式 | 結果 |
|---|---|
.length | 8 |
[...].length | 5 |
| 人間が数える | 1 |
家族の絵文字は、男 + 接合子 + 女 + 接合子 + 女の子 の5つのコードポイントでできています。 「接合子」は ZWJ(ゼロ幅接合子) という見えない文字で、「この2つをくっつけて1つの絵にしてください」という指示です。
人間の感覚(1文字)で数えるには、専用の道具が要ります。
const seg = new Intl.Segmenter("ja", { granularity: "grapheme" });
[...seg.segment("👨👩👧")].length1 が返ります。 Intl.Segmenter は Node.js 16 以降と、いまのブラウザで使えます。
「文字数制限」を実装するときは、まず「どの数え方の文字数か」を決めてください。
.lengthでチェックして MySQL に入れると、フロントで通ったものがデータベースで弾かれます。 数え方が違うからです。
もう1つ: 見た目が同じで、中身が違う文字
const a = "が";
const b = "か" + "゙";
a === b
a.length
b.length
a === b.normalize("NFC")| 式 | 結果 |
|---|---|
a === b | false |
a.length | 1 |
b.length | 2 |
a === b.normalize("NFC") | true |
「が」には2つの書き方があります。 1文字として持つ方法(NFC)と、「か」+「濁点」の2文字として持つ方法(NFD)です。
macOS がファイル名にこの2つ目を使うため、「同じ名前のはずのファイルが一致しない」という事故が起きます。
入力を受け取ったら、
normalize("NFC")を通してから保存する、と決めておくと安全です。
URL のエンコードも、ここで繋がります。
encodeURIComponent("あ")'%E3%81%82' が返ります。 ①で od を打って見た e3 81 82 そのものです。 % エンコードは、「UTF-8 のバイトを1つずつ % と16進数で書く」だけの仕組みです。
.exit または Ctrl-D で Node.js を抜けます。
つまずいたところ
| 症状 | 原因 |
|---|---|
iconv: illegal input sequence at position N | -f が間違っています。 そのバイト列は、指定した文字コードとして成立していません。候補を総当たりしてください |
iconv で ① や ㈱ だけ変換に失敗する | -f SHIFT_JIS を指定しています。 Windows 由来のファイルは CP932 を指定してください |
| 変換したはずのファイルが空になった | > 同じファイル名 でリダイレクトしました。 リダイレクトは先にファイルを空にします。別名に出してください |
ERROR 1366 Incorrect string value: '\xF0...' | 列が utf8mb3。 \xF0 は4バイト文字の先頭。CONVERT TO CHARACTER SET utf8mb4 |
ALTER TABLE ... DEFAULT CHARACTER SET utf8mb4 で直らない | 既存の列は変わりません。 CONVERT TO CHARACTER SET を使ってください |
ERROR 1071 Specified key was too long | 索引は 3072 バイトまで。 KEY (列(191)) にするか、列を短くする |
Illegal mix of collations | JOIN する2つの列で照合順序が違います。 片方を CONVERT TO で揃える |
DBもアプリも utf8mb4 なのに化ける | 接続の文字コードです。 SET NAMES utf8mb4 と、接続設定の charset |
| 化けた文字列が「正しい UTF-8」と判定される | 二重エンコードです。 ⑧の CONVERT(BINARY(...))。必ずバックアップしてから |
bad interpreter: No such file or directory | CRLF です。 file で確認して sed -i 's/\r$//' |
#!/bin/bash があるのに実行できない | BOM です。 head -c 3 ファイル | od -An -tx1 で ef bb bf を確認 |
JSON.parse が1文字目で落ちる | BOM です。 目で見ても分かりません |
<meta charset="utf-8"> があるのに化ける | HTTP ヘッダが勝っています。 curl -sI で確認 |
grep が一致しない、sed が置換しない | 行末に CR が残っています。 cat -A で ^M$ を確認 |
ls で日本語ファイル名が数字の羅列になる | ロケールです。 locale を確認し、LANG=C.UTF-8 などを設定 |
.length は通ったのに DB で弾かれた | 数え方が違います。 JS は UTF-16 単位、MySQL は文字数、列の上限はバイト数 |
いちばん時間を溶かしたのは、ALTER TABLE ... DEFAULT CHARACTER SET です。
SHOW CREATE TABLE を打って DEFAULT CHARSET=utf8mb4 と出ているのに、INSERT はまだ ERROR 1366 で落ちる。「MySQL が壊れている」と本気で思いました。 実際は、SHOW CREATE TABLE の出力の下の方、列の定義に CHARACTER SET utf8mb3 と、ちゃんと書いてありました。 読んでいなかっただけです。
もう1つは、化けた CSV を「直った」と思って保存し直したことです。
Excel で開いて化けていたので、いったん別のエディタで開いて、読める文字コードを探して、そのまま保存しました。そのとき、変換できない文字が ? になっていることに気づきませんでした。 元ファイルはもう上書きしていました。
これが、この記事の冒頭を「壊れたのではない」から始めた理由です。 化けているだけなら戻せます。
?に置き換わったら戻せません。 だから、直す前に必ずcpでコピーを取ってください。 それだけで防げます。
ロケール —— 端末側の設定も文字コードです
最後に短く1つ。ファイルではなく「いま動いているシェル」の設定です。
LANG=C.UTF-8 や LANG=en_US.UTF-8 のように、末尾が UTF-8 になっていれば大丈夫です。
LANG=C や POSIX になっていると、こうなります。
日本語のファイル名が、エスケープされた数字の羅列になります。 ファイル名自体は壊れていません。 表示のときに「この端末は ASCII しか出せない」と判断されているだけです。
元に戻ります。 LANG=C ls の書き方は、そのコマンドの実行中だけ環境変数を変えるというものです。
もう1つ、LC_COLLATE は並び順を決めます。
スクリプトの中で
sortを使うときは、LC_ALL=C sortと書くのが安全です。 ロケールによって並び順が変わるため、同じスクリプトが環境によって違う結果を出します。
後片づけ
VM の作業用ファイルを消します。
MySQL の練習用テーブルを消します。
USE appdb;
DROP TABLE IF EXISTS d_enc3, d_enc_idx;
SHOW TABLES;
tasks・users・sessionsが残っていて、d_で始まる表が1枚も無ければ元通りです。
⑪で nginx を触った場合は、必ず戻します。
charset euc-jp; を charset utf-8; に戻して(行ごと消しても構いません)、確認します。
入れたコマンドが要らなければ、消せます。
xxdは残しておくことをおすすめします。 バイトを見る癖が、この先いちばん効きます。
まとめ
- 文字化けは「文字が壊れた」のではない。 書いたときと読むときで、解釈の表が違うだけ
- バイト列が残っていれば戻せる。 化けた状態で保存し直すと戻せなくなる。 直す前に必ずコピーを取る
- 文字は数字。
echo -n "あ" \| od -An -tx1でe3 81 82の3バイト。「A」は1バイト - 1バイトは256通りしかない。 日本語は数万文字あるので、複数バイトになるしかない
- 文字集合と符号化方式は別の話。 Unicode は番号表、UTF-8 は書き方
- 同じ
U+3042を、UTF-8 は3バイト、UTF-16 は2バイトで書く。 「Unicode で保存」は、たいてい UTF-16 のこと - Windows 由来の日本語ファイルは
SHIFT_JISではなくCP932。 ①や㈱で差が出る iconv -f A -t Bの-fが「読むときの表」。 文字化けは-fを間違えた状態そのもの-cは変換できないバイトを黙って捨てる。 本番のデータに使わない- 化け方には特徴がある。 「縺」「繧」だらけなら元は UTF-8 のひらがな。 「�」だらけなら元は CP932 か EUC-JP
file --mime-encodingとnkf --guessは推測。 確定させるには候補を総当たりして、読めるものを選ぶ- MySQL の
utf8は UTF-8 ではない。utf8mb3の別名で、絵文字(4バイト)が入らない - 日本語のほとんどは3バイトなので、
utf8mb3でも動いてしまう。 絵文字が来た日に初めて落ちる CHAR_LENGTHが文字数、LENGTHがバイト数。VARCHAR(100)の 100 は文字数- 照合順序は「どう比べるか」。
utf8mb4_0900_ai_ci= Unicode 9.0 / アクセント無視 / 大文字小文字無視 - 既定はひらがなとカタカナ、全角と半角を同じとみなす。 区別したければ
ja系の_ks ALTER TABLE ... DEFAULT CHARACTER SETでは既存の列は直らない。CONVERT TO CHARACTER SETを使う- 索引は 3072 バイトまで。
utf8mb4は1文字4バイトなので、768文字が上限 VARCHAR(191)は、昔の 767 バイト制限の名残。 いま機械的に真似する必要はない- DB もアプリも
utf8mb4なのに化けるなら、接続の文字コード。SET NAMES utf8mb4と、接続設定に明示 - 二重エンコードは「正しい UTF-8」として保存されるので、機械は正常と言う。 人間が読むことだけが手がかり
- 改行コードは LF(Linux)と CRLF(Windows)。
fileとcat -Aで見える - CRLF のシェルスクリプトは
bad interpreter: /bin/bash^Mで落ちる。sed -i 's/\r$//'で直る core.autocrlfは各自の PC の設定。 リポジトリで決めるなら.gitattributesに* text=auto eol=lf- BOM は先頭の
EF BB BF。catでもnanoでも見えない。head -c 3 ファイル \| od -An -tx1で見る - Linux で使うファイルに BOM を付けない。 Excel に読ませる CSV には付ける
- Windows の PowerShell の
>は UTF-8 とは限らない。 VM で使うファイルを Windows 側で作らない - VS Code の右下に
UTF-8とLFが出ている。 この記事の8割は、あれを読めるかどうか - 文字コードの申告は BOM > HTTP ヘッダ >
<meta charset>の順に強い <meta charset>は先頭 1024 バイト以内。 前に長いコメントを置くと読まれない- JavaScript の文字列は UTF-16。
.lengthは文字数ではなく UTF-16 の単位の数 "𩸽".lengthは 2、[..."𩸽"].lengthは 1、UTF-8 では 4 バイト- 絵文字は ZWJ という見えない文字で繋がっている。 人間の感覚で数えるなら
Intl.Segmenter - 見た目が同じで中身が違う文字がある(NFC / NFD)。 入力は
normalize("NFC")を通してから保存する encodeURIComponent("あ")が'%E3%81%82'。%エンコードは UTF-8 のバイトを書いているだけ- 結論: 全部 UTF-8(MySQL は
utf8mb4)に統一する。 変換するのは入口と出口だけ - 入口=外から来たファイルを受け取った直後。出口=Excel や古いシステムに渡す直前。 途中では絶対に変換しない
参考リンク
- roadmap.sh — Backend Developer
- roadmap.sh — Frontend Developer
- The Unicode Consortium(公式) — 文字集合そのものの一次情報
- RFC 3629 — UTF-8, a transformation format of ISO 10646 — UTF-8 のバイトの決まりは、ここが原典です
- WHATWG Encoding Standard — ブラウザが実際にどう文字コードを決めているか
- HTML Standard — Parsing HTML documents —
<meta charset>と 1024 バイトの話はここ - MySQL リファレンスマニュアル(公式・トップ) —
utf8mb4と照合順序は、自分が使っているバージョンを選んで読んでください - PostgreSQL 公式ドキュメント — 文字セットサポート — PostgreSQL はデータベース作成時に文字コードが決まります
- Git — gitattributes —
text=autoとeolの正確な意味 - MDN — String.prototype.length
- MDN — Intl.Segmenter
- nginx — ngx_http_charset_module
次に読む
この記事は 【第5段階】バックエンドとデータベース の 19 / 29 本目です。
| 記事 | |
|---|---|
| ← 前の記事 | 1つの表に全部入れると壊れる — テーブル設計と正規化 |
| → 次の記事 | 9時間ずれるのは全部同じ理由 — 日付と時刻の扱い |
上から順に読めば積み上がるように並べています。 飛ばしても構いませんが、詰まったら前の回に戻ってください。
全体の順路は はじめに にあります。
roadmap.sh のどこをやっているか
文字コードは roadmap.sh に独立項目が無い。日本語を扱うと必ず刺さるので独立させた。
コメント